AI资讯新闻榜单内容搜索-token

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: token
刚刚,Anthropic开源FlashProve,给大模型办了一张「防伪身份证」

刚刚,Anthropic开源FlashProve,给大模型办了一张「防伪身份证」

刚刚,Anthropic开源FlashProve,给大模型办了一张「防伪身份证」

Anthropic 开源了基于零知识密码学的 FlashProve,使用户无需获取模型权重即可验证回答确由指定模型生成;该系统已在 4000 亿参数的 Llama 4 Maverick 上达到约 110 Token/s,但仍是受成本和上下文限制的研究原型。

来自主题: AI资讯
9076 点击    2026-11-04 11:12
多少花了上亿token的Agent Memory系统,效果其实还不如RAG

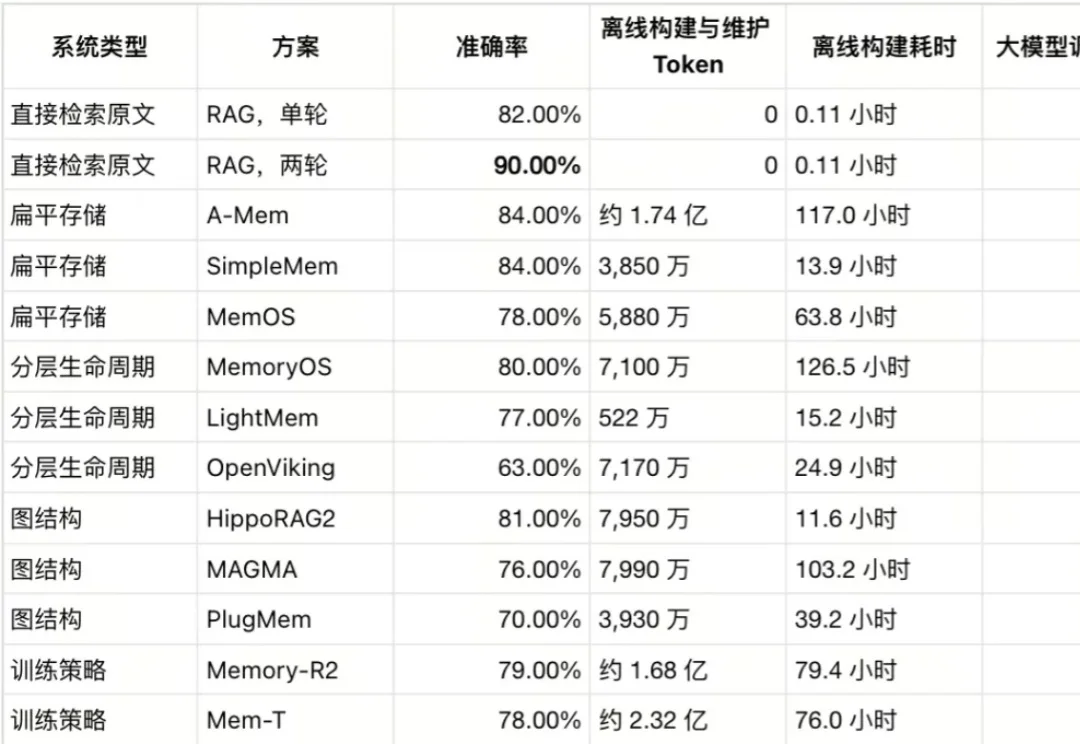
多少花了上亿token的Agent Memory系统,效果其实还不如RAG

多少花了上亿token的Agent Memory系统,效果其实还不如RAG

为 Agent 建记忆,花掉了上亿 Token,结果在相当一部分情况下,回答准确率甚至低于直接用RAG检索聊天记录。

来自主题: AI资讯
6431 点击    2026-11-04 09:52
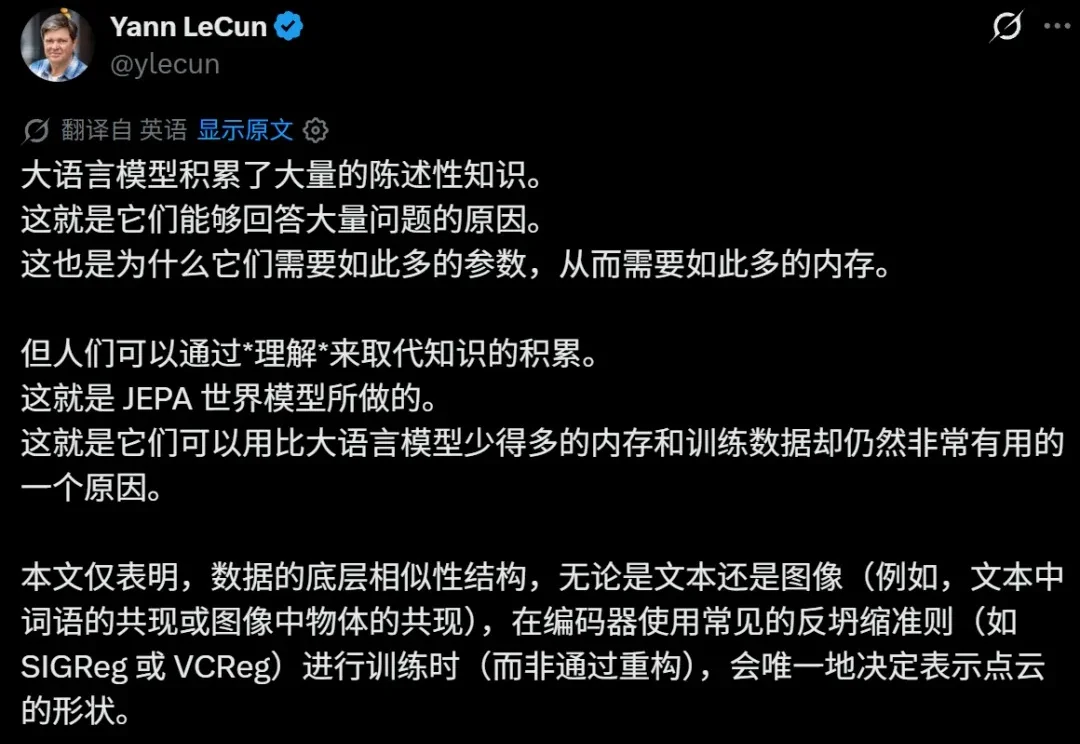
LeCun证明了:规模从未起作用,下一token路线效率低

LeCun证明了:规模从未起作用,下一token路线效率低

LeCun证明了:规模从未起作用,下一token路线效率低

人工智能先驱 Yann LeCun 一直主张「生成式 AI 是一条死胡同,世界模型才是真的未来」。

来自主题: AI技术研报
6184 点击    2026-11-03 11:40
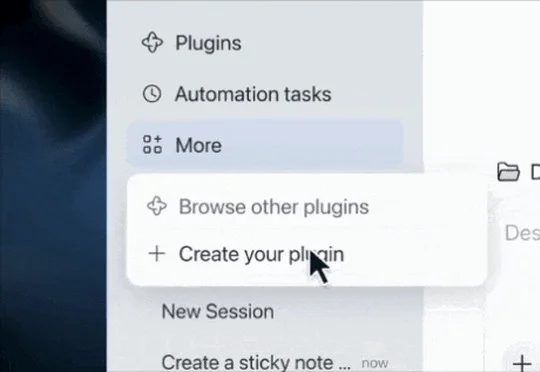
DeepSeek官方智能体教程来了:一句话造插件,7套提示词免费公开

DeepSeek官方智能体教程来了:一句话造插件,7套提示词免费公开

DeepSeek官方智能体教程来了:一句话造插件,7套提示词免费公开

DeepSeek Harness官方发布“创造模式”(Creator Mode)指南,用户输入一句自然语言即可让AI编写并安装插件,同时免费公开7套官方提示词,示例覆盖3D建模与游戏、视频剪辑、海报设计、论文阅读、界面改造和Token统计。

来自主题: AI资讯
9293 点击    2026-11-03 09:57
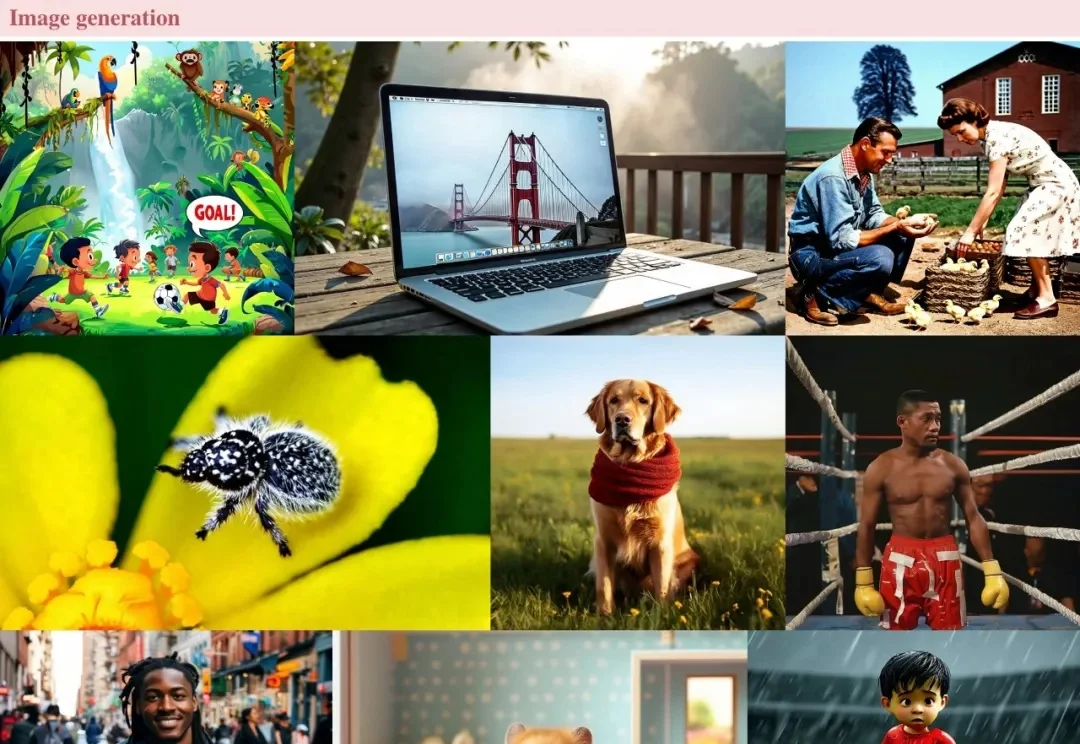
告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。

来自主题: AI技术研报
8811 点击    2026-11-02 10:33
ChatGPT和Codex要共用额度了,无限聊天的时代结束了。

ChatGPT和Codex要共用额度了,无限聊天的时代结束了。

ChatGPT和Codex要共用额度了,无限聊天的时代结束了。

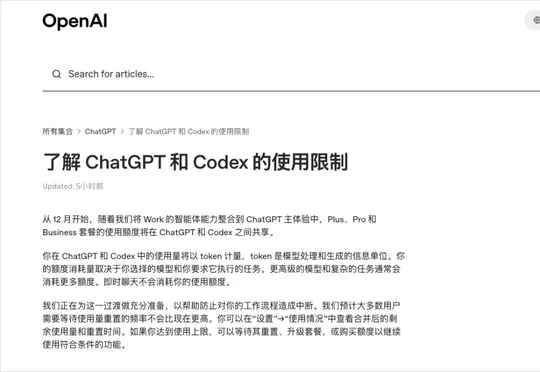
OpenAI将从12月起合并Plus、Pro用户的ChatGPT与Codex用量额度并统一按Token计费,基础Instant聊天除外,ChatGPT近乎无限的聊天额度将结束。

来自主题: AI资讯
9313 点击    2026-11-01 14:27
智能体年均增长超一倍,百度智能云给智能体配了套新底座

智能体年均增长超一倍,百度智能云给智能体配了套新底座

智能体年均增长超一倍,百度智能云给智能体配了套新底座

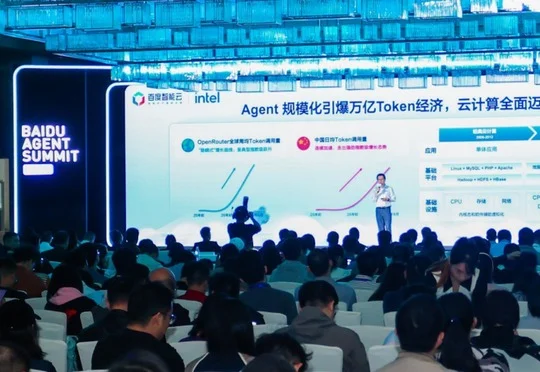
百度智能云推出AI Infra与Agent Infra双层基础设施,通过百舸AI计算平台6.0提升资源与Token效率,支撑智能体长期稳定运行及产业场景落地。

来自主题: AI资讯
8112 点击    2026-11-01 09:18
蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD

蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD

蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD

清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。

来自主题: AI技术研报
7265 点击    2026-10-31 12:08
NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

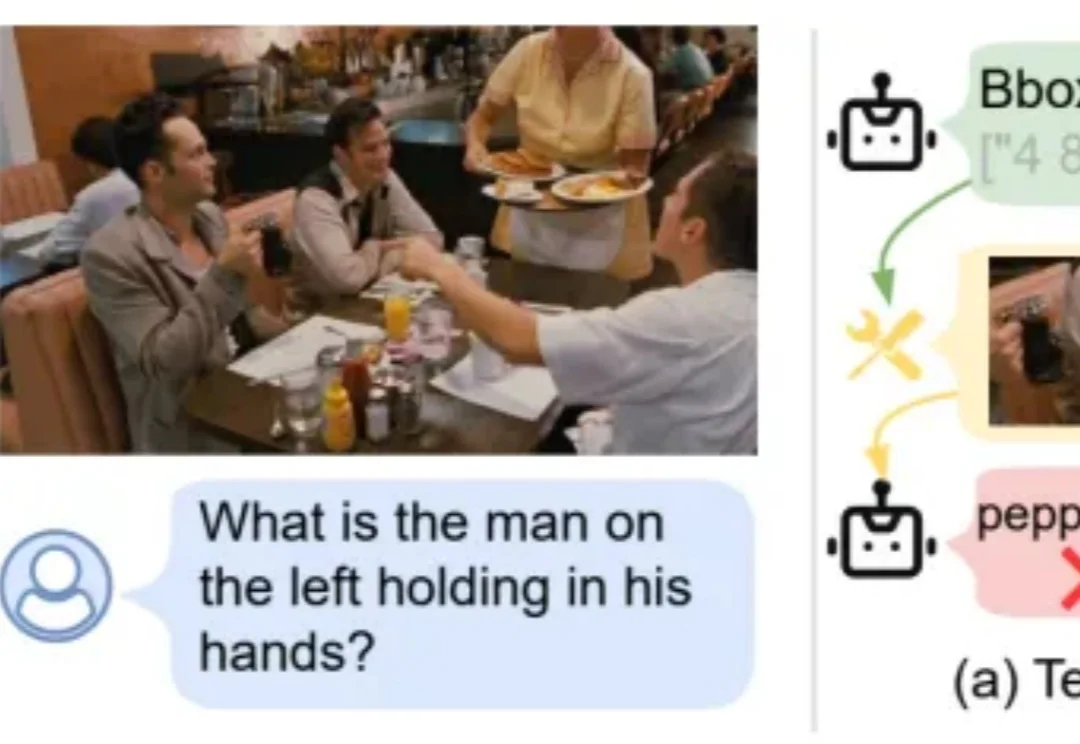
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?

来自主题: AI技术研报
6687 点击    2026-10-29 11:09