NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源
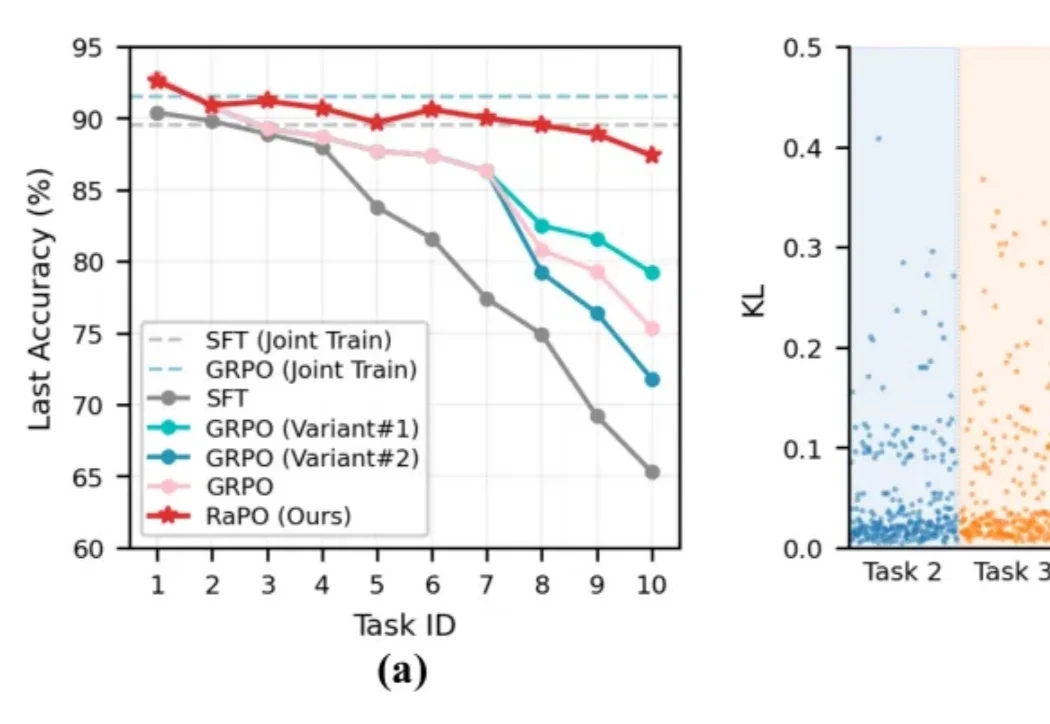
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
搜索
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
据Z Finance报道,周畅已离开字节Seed、转向Physical AI创业并获头部美元基金投资,但接近字节的人士否认离职;Seed将VLM并入LLM体系,折射出多模态统一路线调整。
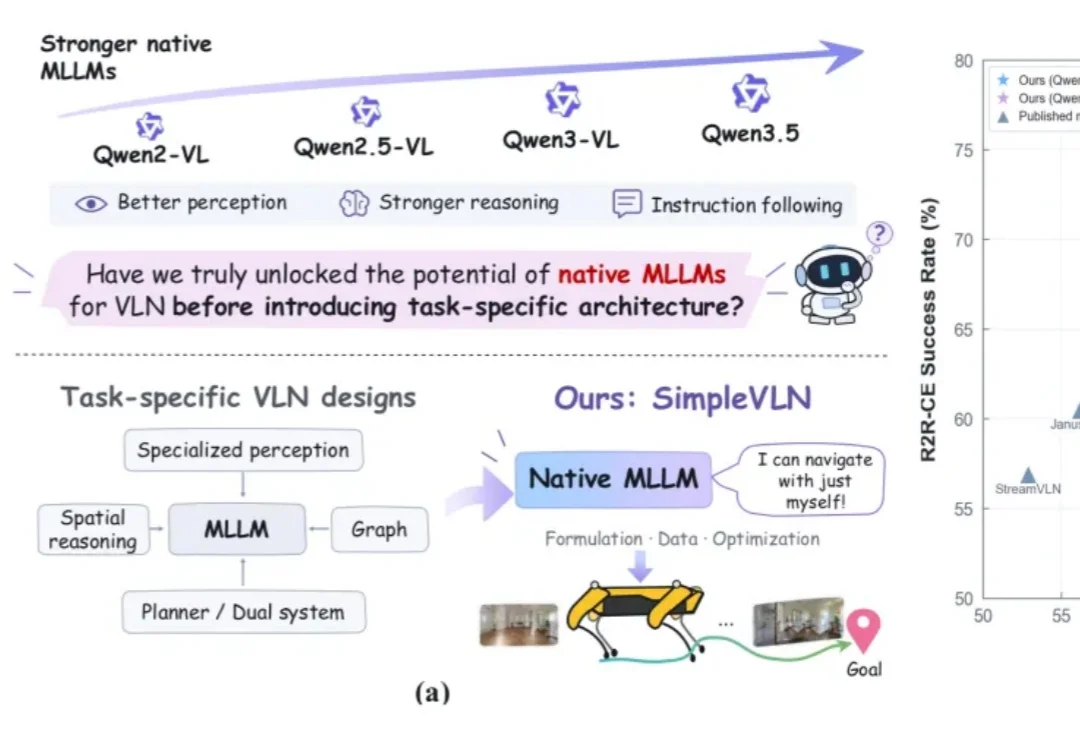
设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
还得是「源神」D老师,善呐!
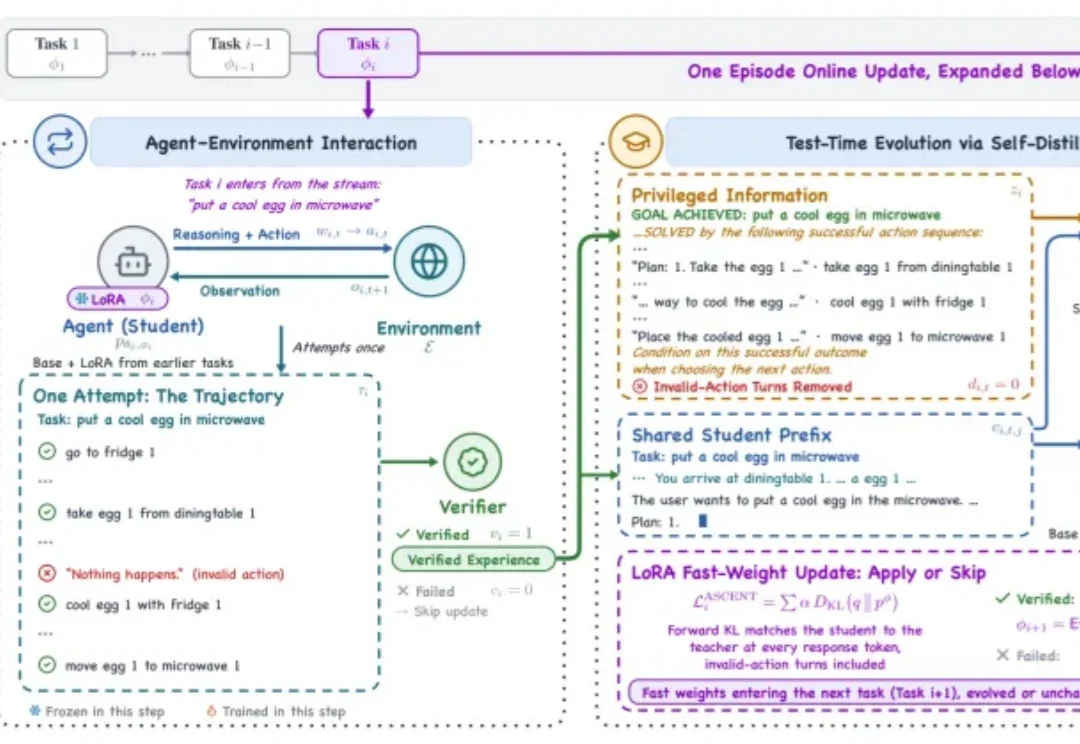
LLM智能体如何在部署过程中,通过自身执行持续进化?
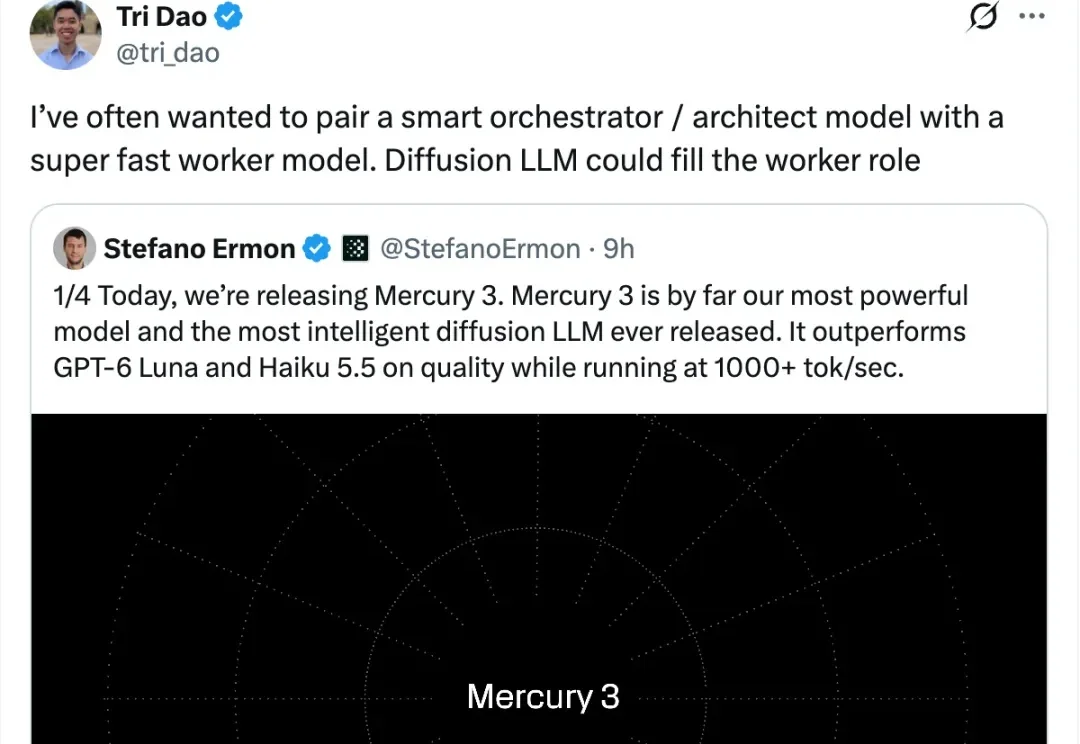
GPT-6 Luna 要被扩散 LLM 抢饭碗了?
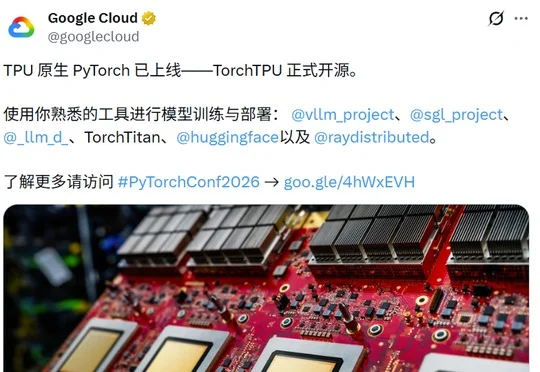
谷歌与Meta联合开源TorchTPU,使TPU成为PyTorch原生设备,并完成vLLM、SGLang、Hugging Face、Ray、TorchTitan等主流项目接入,CUDA的软件生态护城河开始松动。
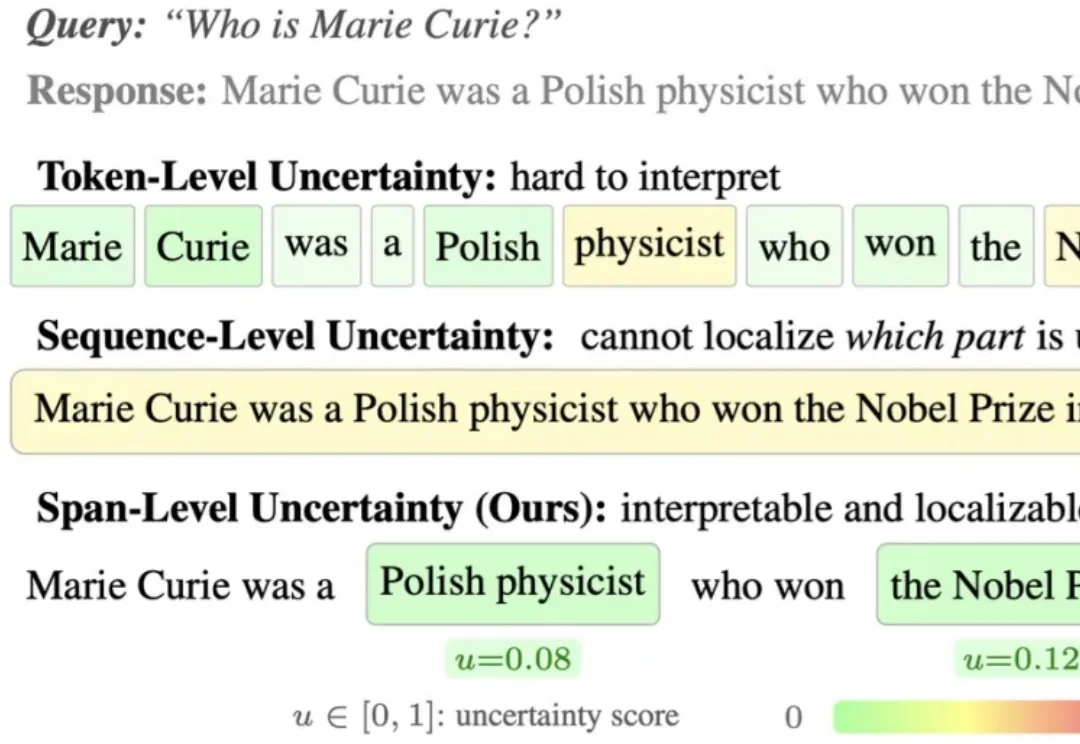
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?
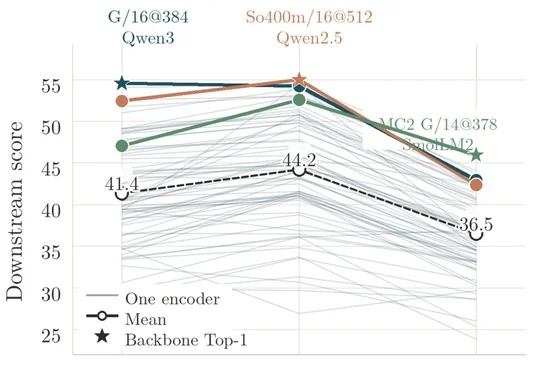
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
真是活久见! 连Linux之父,都让Claude来写内核了。就在最近,一位开发者在刷新Linus的官方内核仓库时,赫然发现了一个极不寻常的新分支——noref-filemap-read-with-llm