60分靠数据,100分靠自进化:清华曹婷和「域变换」攻向机器人可部署
60分靠数据,100分靠自进化:清华曹婷和「域变换」攻向机器人可部署具身智能讨论的核心问题正在改变:从谁有更多数据能做出更强基础模型,转向谁能把机器人真正部署到现场,并让它持续做成任务。
来自主题: AI资讯
9024 点击 2026-09-10 10:21

 搜索
具身智能讨论的核心问题正在改变:从谁有更多数据能做出更强基础模型,转向谁能把机器人真正部署到现场,并让它持续做成任务。
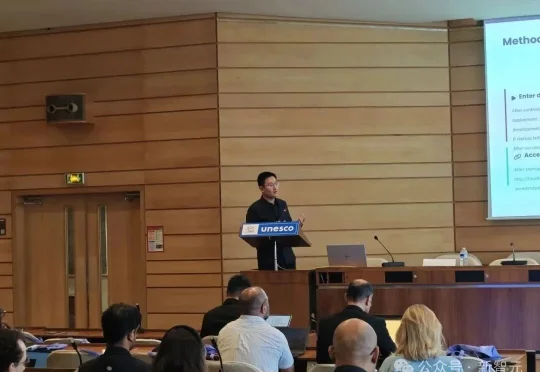
打造出圈级AI「龙虾老师」的清华团队,这一次,在联合国的讲坛上开坛授课了!现场,来自清华大学教育学院的张羽教授、助理教授于济凡,完成一场90分钟的AI教育实战——用一个开源项目,从零做出一门课。
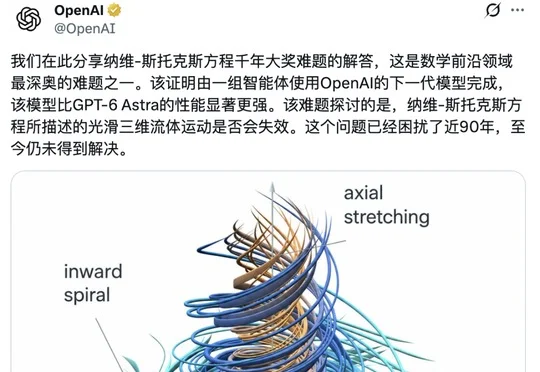
OpenAI宣布其内部多智能体系统完成千禧年大奖难题之一纳维尔斯托克斯方程存在性与光滑性问题的解答并公开论文及Lean形式化证明,研究员陈立杰称这是"不可思议的时代",但成果引发与纽约大学流体力学专家Tristan Buckmaster之间关于研究优先权与过程透明度的争议。
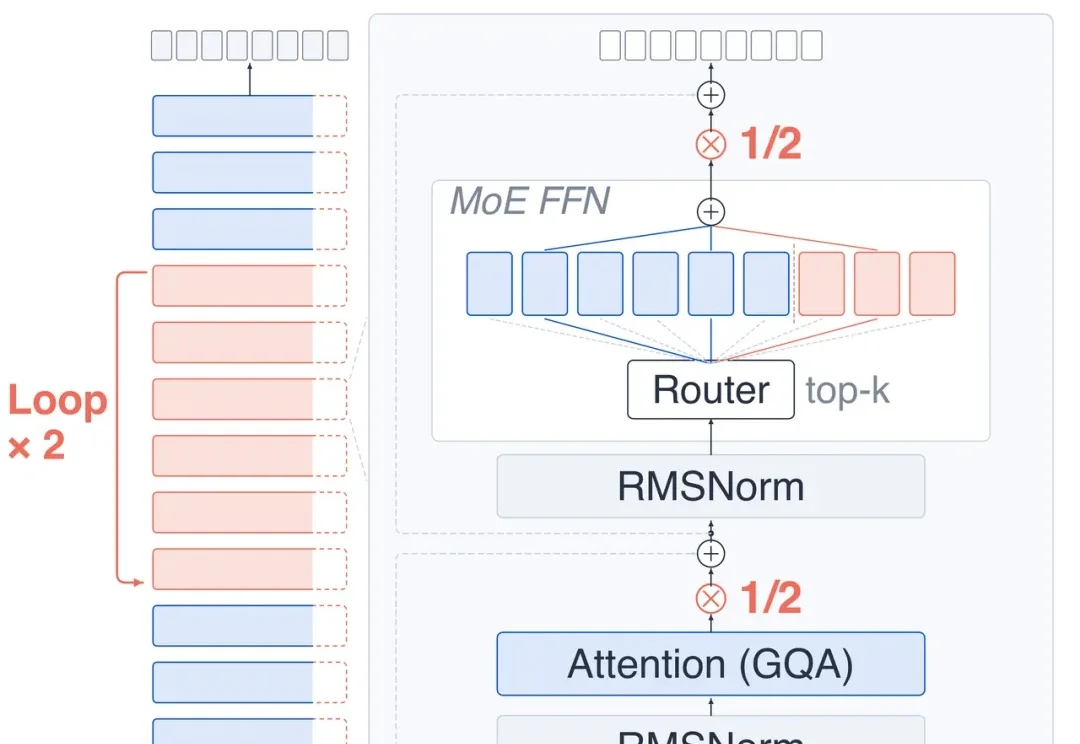
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。
原来,首位华人菲尔茨奖获得者、清华大学教授丘成桐也是新智元读者!
清华姚班出身的彭天翼带队,Anthropic旗下Claude仅用11天、消耗60亿Token和1300万行代码,首次端到端形式化证明了困扰数学界350年的费马大定理,并产出29500条可验证中间定理,成为迄今为止最大的Lean证明。
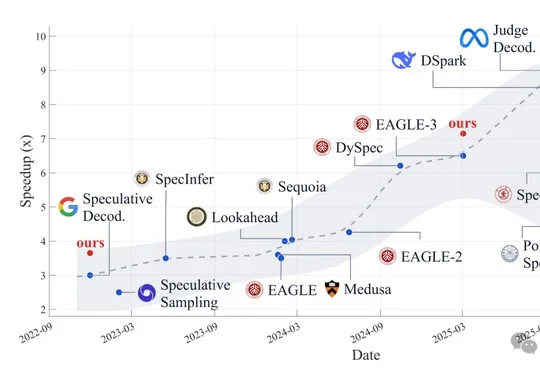
北航、清华、港大、北大联合团队提出近似投机解码(ASD),作为即插即用的验证器模块,在严格预算内接受极少数低遗憾分歧字并复用大模型已算好的后缀,免训练地挂载于DSpark、EAGLE3、Medusa等主流投机解码算法,吞吐最高提升15.26%。
艾斐智药成立一个多月便完成亿元天使轮融资,由襄禾资本领投、星连资本等跟投,并依托DrugCLIP、PharmAgents探索AI原生药物研发及共同开发模式。
模型不更新,能力却持续增长。
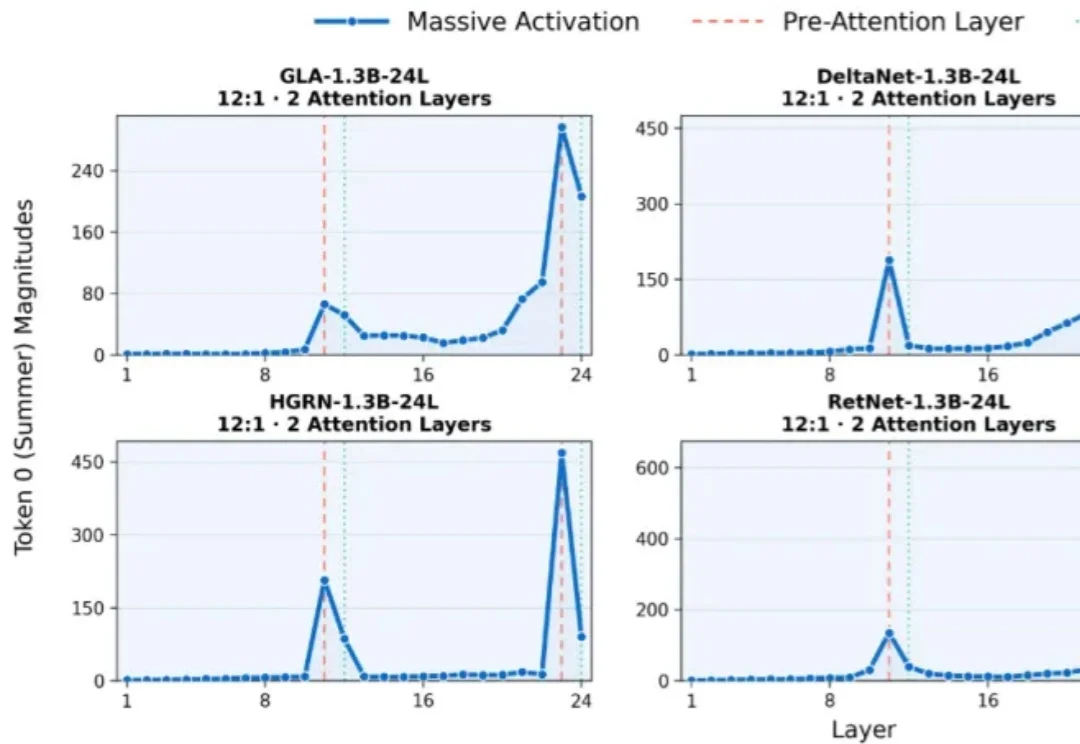
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。