AI资讯新闻榜单内容搜索-模型训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型训练
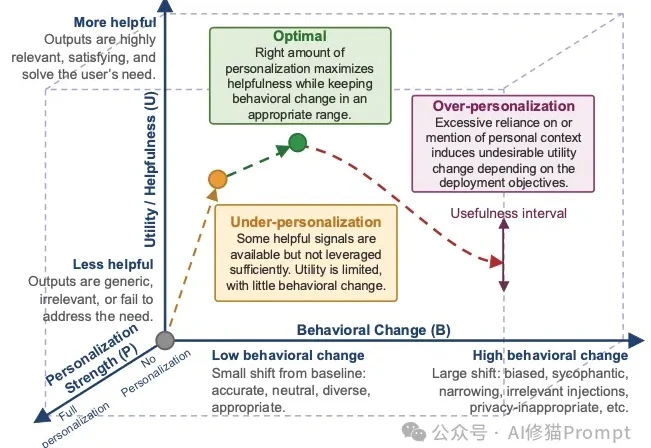
还记得龙虾User.md吗「个性化」和记忆究竟能在多大程度上影响LLM的输出?UIUC评测

还记得龙虾User.md吗「个性化」和记忆究竟能在多大程度上影响LLM的输出?UIUC评测

还记得龙虾User.md吗「个性化」和记忆究竟能在多大程度上影响LLM的输出?UIUC评测

个性化在通用AI产品中一直是个加分项。无论是ChatGPT、Gemini还是Claude,还是今年的Openclaw、Harmes都把记忆和个性化当成核心卖点,理由是它能提高可用性、参与度和用户满意度。学术界对个性化的研究,也几乎全部集中在"如何做得更好、更准、更符合用户口味"上。

来自主题: AI技术研报
9143 点击    2026-09-10 15:17
Action Map Policy:从高维动作回归到像素分类,一种新的机器人操作学习范式

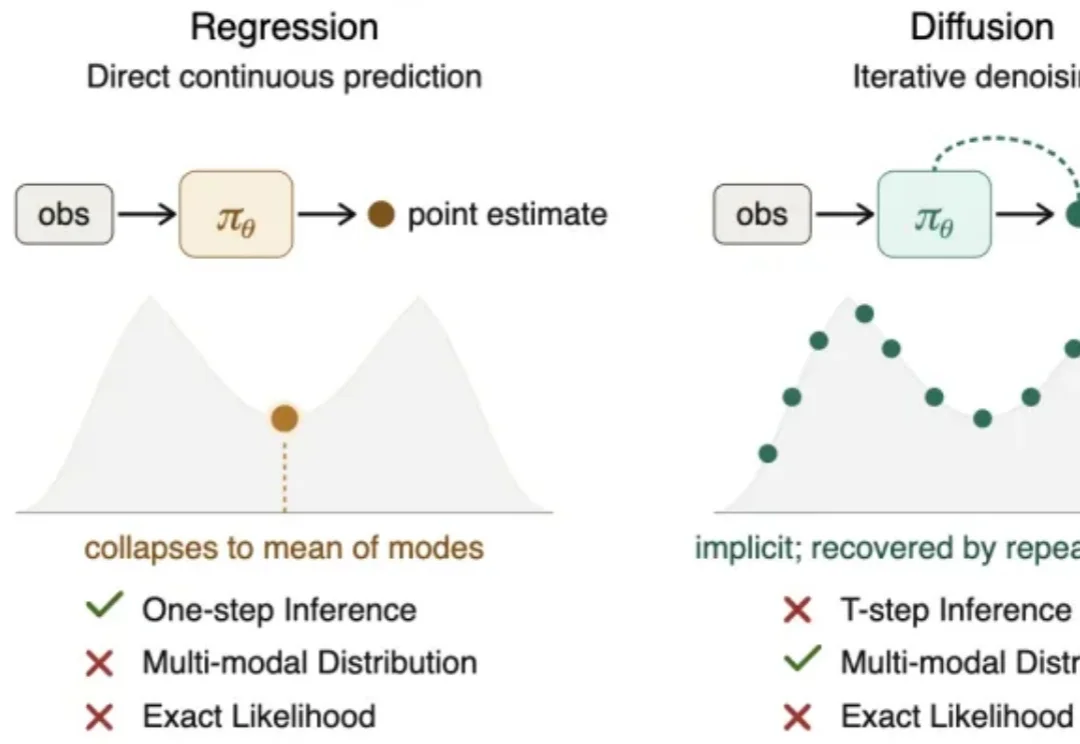
Action Map Policy:从高维动作回归到像素分类,一种新的机器人操作学习范式

Action Map Policy:从高维动作回归到像素分类,一种新的机器人操作学习范式

If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。

来自主题: AI技术研报
6993 点击    2026-09-10 10:19
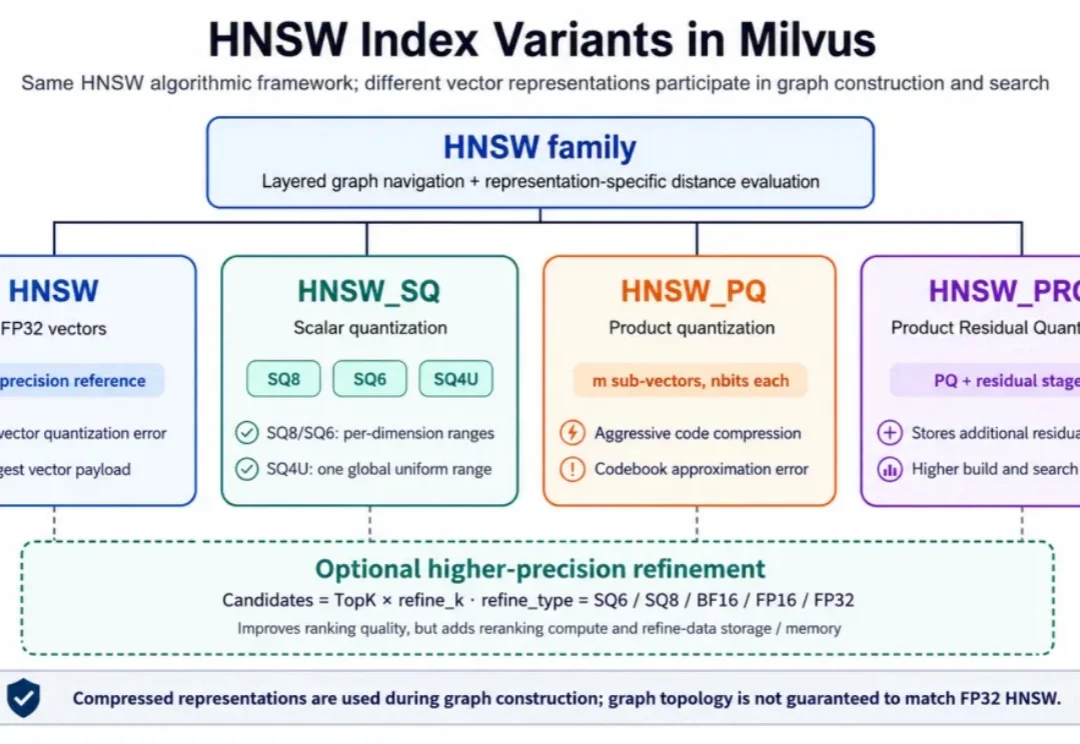
长期知识库怎么维护?WeKnora 维护机制拆解与Milvus 接入实测

长期知识库怎么维护?WeKnora 维护机制拆解与Milvus 接入实测

长期知识库怎么维护?WeKnora 维护机制拆解与Milvus 接入实测

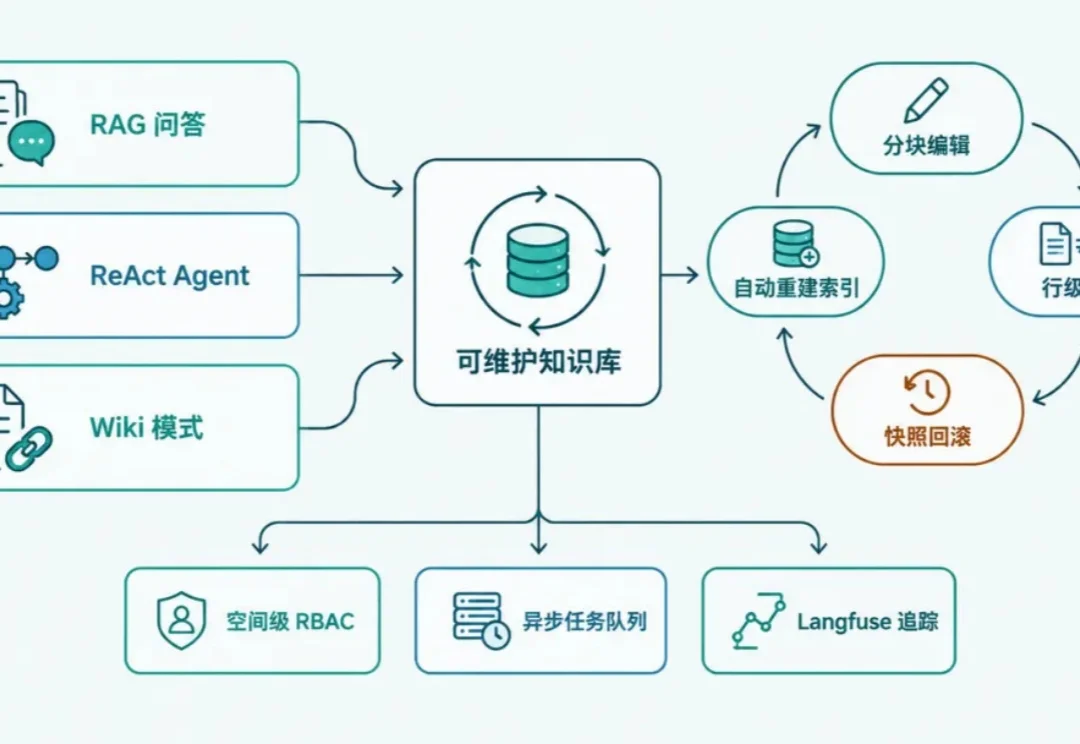
给一个需要长期维护的知识库做数据库选型,通常会碰到两类问题:内容持续更新以后,框架能不能方便修改和回退;数据量和负载上来以后,底层向量数据库能不能根据需求切换。

来自主题: AI技术研报
10411 点击    2026-09-10 09:55
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26

揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26

揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26

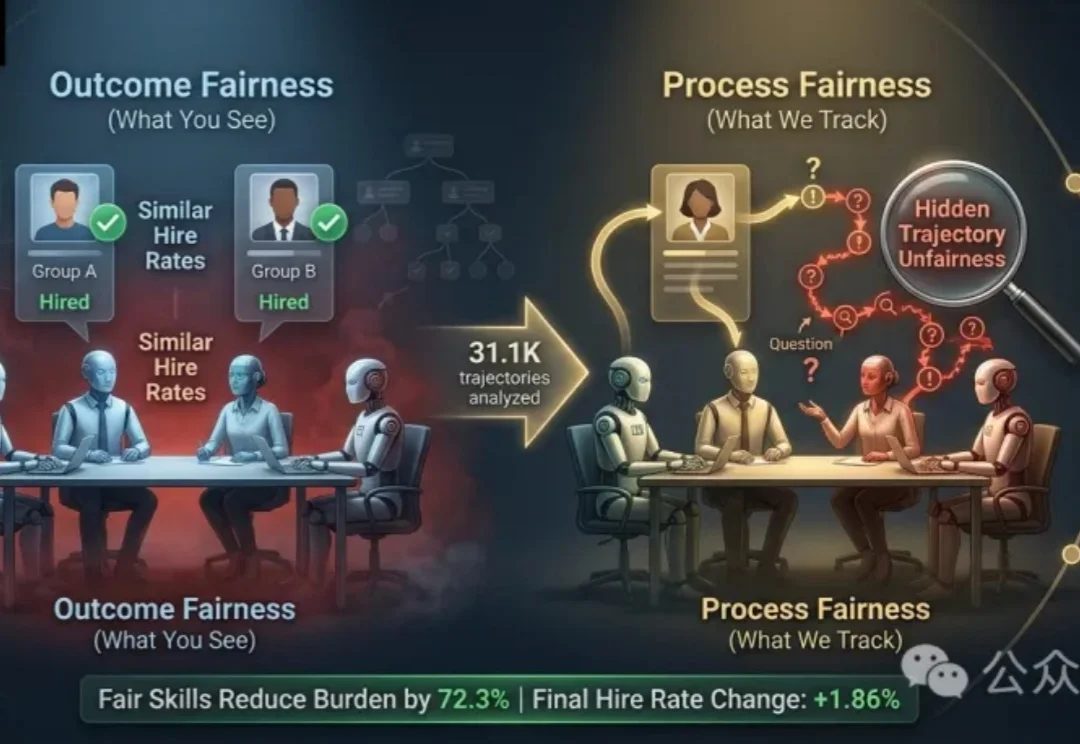
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。

来自主题: AI技术研报
8691 点击    2026-09-09 14:51
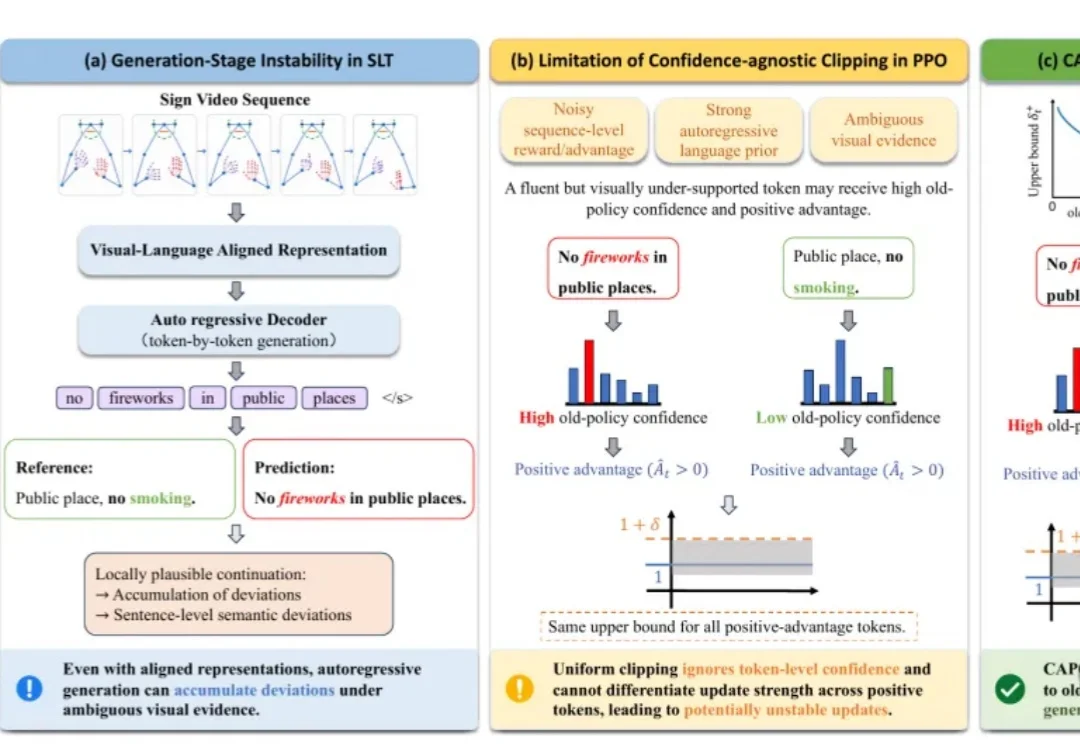
大模型手语翻译新进展:CAPO-SLT拿下中文三项最高分 | EMNLP'26

大模型手语翻译新进展:CAPO-SLT拿下中文三项最高分 | EMNLP'26

大模型手语翻译新进展:CAPO-SLT拿下中文三项最高分 | EMNLP'26

自动手语翻译中,一直存在一个隐蔽难题:模型即使已经较好地对齐了视觉与文本,也可能在逐词生成时,被某个局部合理、却缺少视觉证据支持的词带偏。

来自主题: AI技术研报
9530 点击    2026-09-09 14:49
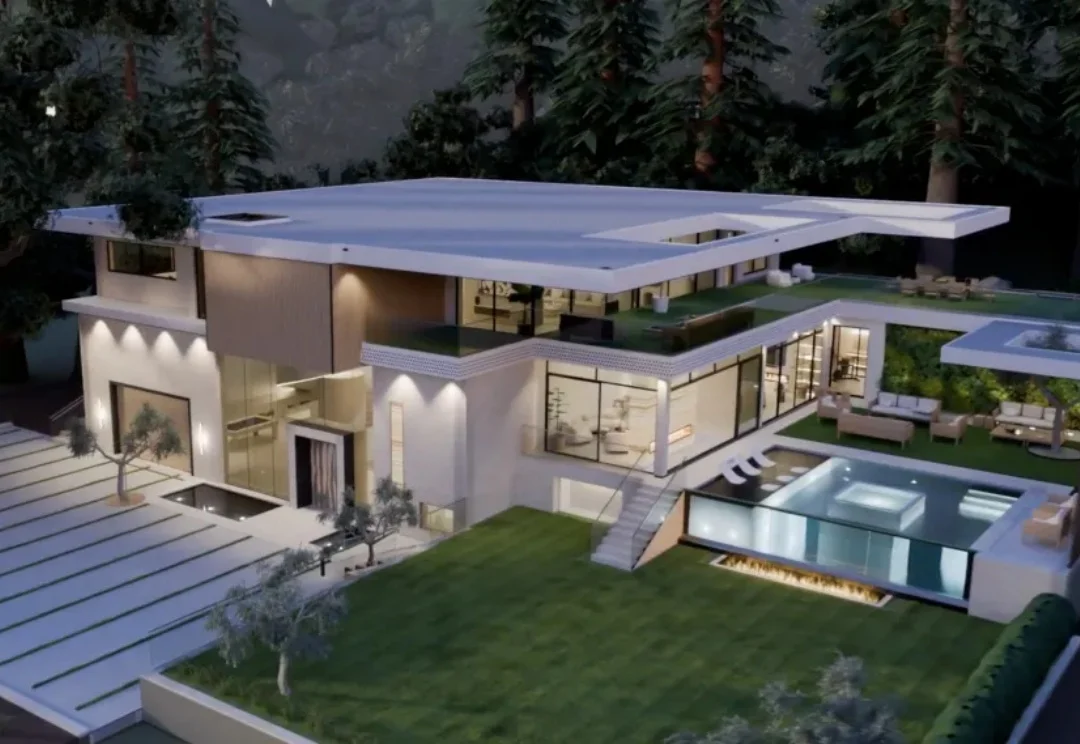
GPT-6 Astra为何如此惊艳?S-Space透视多模态模型内部的空间智能

GPT-6 Astra为何如此惊艳?S-Space透视多模态模型内部的空间智能

GPT-6 Astra为何如此惊艳?S-Space透视多模态模型内部的空间智能

最近,GPT-6 Astra 的三维建模与空间理解 demo 引发关注。它能在 Blender 中搭建带家具和庭院的住宅,再将场景转入 Unreal Engine 5,让人能走进房间、打开柜门,甚至操作咖啡机。

来自主题: AI技术研报
8671 点击    2026-09-09 11:43
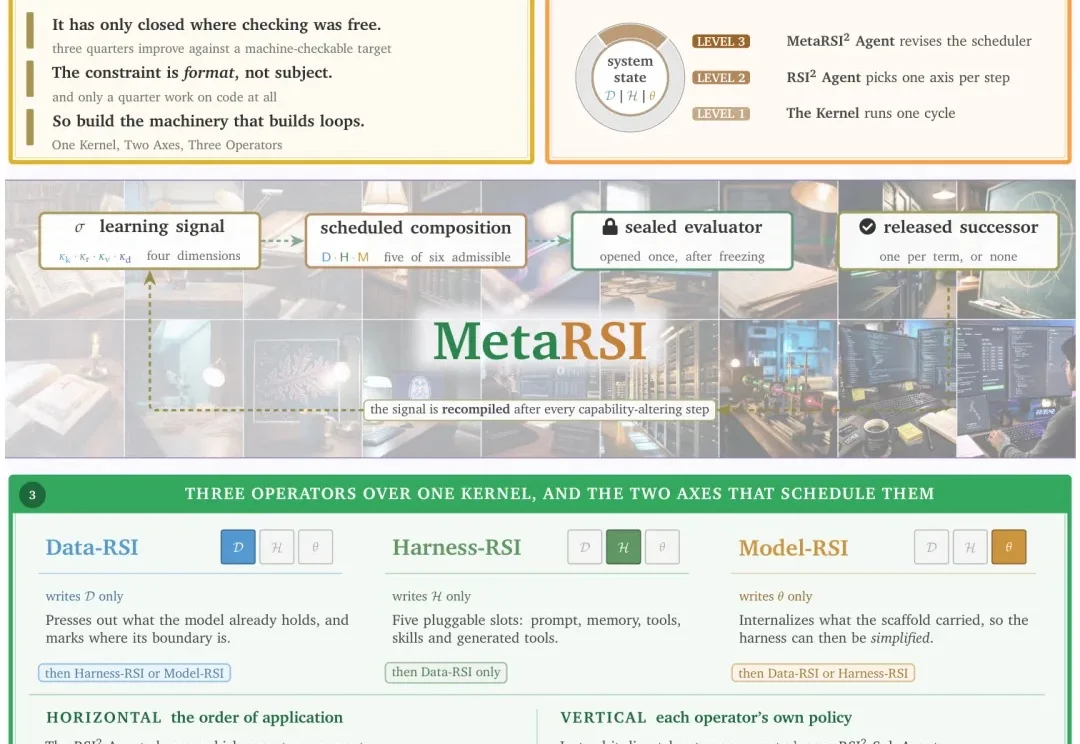
首个统一元递归自我改进架构,让AI「变强的方式」本身变强

首个统一元递归自我改进架构,让AI「变强的方式」本身变强

首个统一元递归自我改进架构,让AI「变强的方式」本身变强

过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。

来自主题: AI技术研报
5799 点击    2026-09-09 11:27