首个统一的图像与视频AIGC可解释性检测框架,多榜单SOTA性能
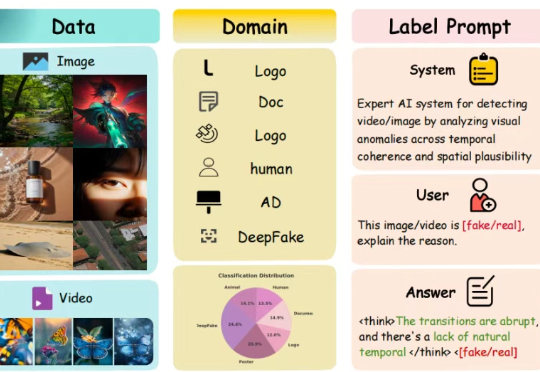
首个统一的图像与视频AIGC可解释性检测框架,多榜单SOTA性能想象一下:你正在浏览社交媒体,看到一张震撼的图片或一段令人震撼的视频。它栩栩如生,细节丰富,让你不禁信以为真。但它究竟是真实记录,还是由顶尖 AI 精心炮制的「杰作」?如果一个 AI 工具告诉你这是「假的」,它能进一步解释理由吗?它能清晰指出图像中不合常理的光影,或是视频里一闪而过的时序破绽吗?
搜索
想象一下:你正在浏览社交媒体,看到一张震撼的图片或一段令人震撼的视频。它栩栩如生,细节丰富,让你不禁信以为真。但它究竟是真实记录,还是由顶尖 AI 精心炮制的「杰作」?如果一个 AI 工具告诉你这是「假的」,它能进一步解释理由吗?它能清晰指出图像中不合常理的光影,或是视频里一闪而过的时序破绽吗?
研究多智能体必读指南。Anthropic 发布了他们如何使用多个 Claude AI 智能体构建多智能体研究系统的精彩解释。
研究人员发现,大语言模型的遗忘并非简单的信息删除,而是可能隐藏在模型内部。通过构建表示空间分析工具,区分了可逆遗忘和不可逆遗忘,揭示了真正遗忘的本质是结构性的抹除,而非行为的抑制。
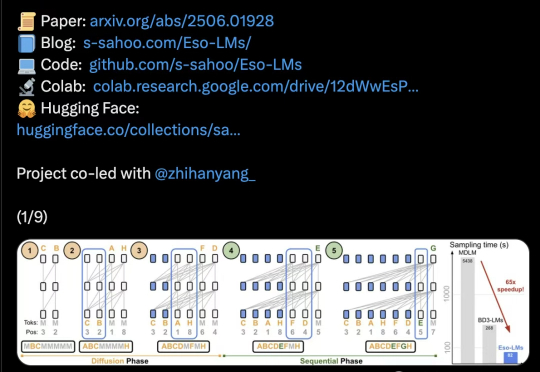
扩散建模+自回归,打通文本生成任督二脉!这一次,来自康奈尔、CMU等机构的研究者,提出了前所未有的「混合体」——Eso-LM。有人惊呼:「自回归危险了。」
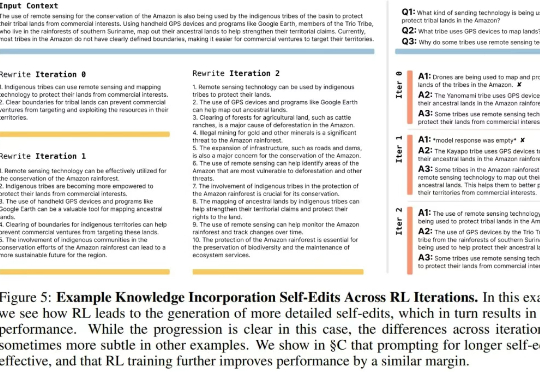
近段时间,关于 AI 自我演进/进化这一话题的研究和讨论开始变得愈渐密集。
三维场景是构建世界模型、具身智能等前沿科技的关键环节之一。
大型推理模型(LRMs)在解决复杂任务时展现出的强大能力令人惊叹,但其背后隐藏的安全风险不容忽视。
人类在学习新知识时,总是遵循从“记忆事实”到“理解概念”再到“掌握技能”的认知路径。
为了推动该领域加速健康发展,由上海交通大学、上海 AI 实验室、牛津大学、普林斯顿大学、Meta 等十个机构联合推出的 MASLab,带来首个统一、全面、研究友好的大模型多智能体系统代码库:
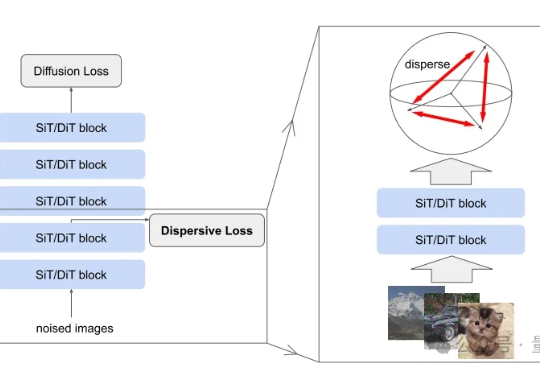
扩散模型风头正盛,何恺明最新论文也与此相关。 研究的是如何把扩散模型和表征学习联系起来—— 给扩散模型加上“整理收纳”功能,使其内部特征更加有序,从而生成效果更加自然逼真的图片。