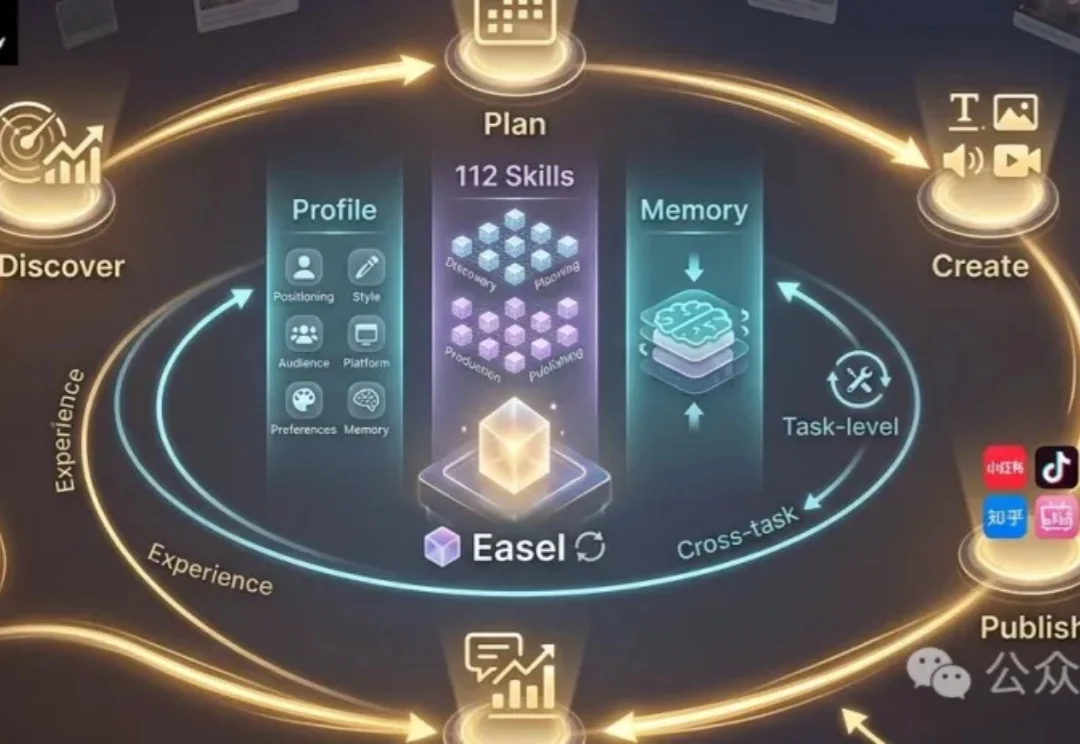
自进化社媒Agent!浙大x北大:从多模态任务编排到反馈驱动
自进化社媒Agent!浙大x北大:从多模态任务编排到反馈驱动当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
来自主题: AI技术研报
9596 点击 2026-09-16 14:40

 搜索
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
拿Agent做Coding,想必大家都已经很熟悉了。
一个 Agent 第一次没把任务做对。
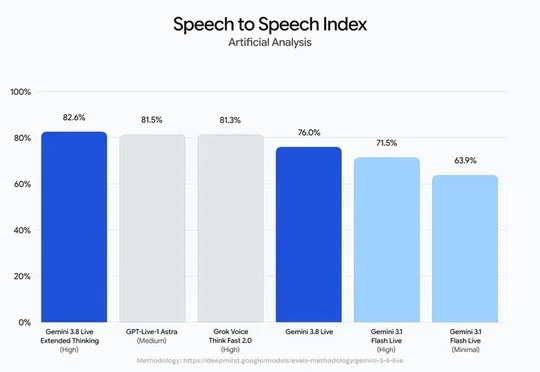
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
GPT-6 Astra 把大模型的能力边界,又向 3D 世界推了一步。它可以操作 Blender、编写代码,直接生成 3D 模型和场景。当通用模型开始学会建模,专门做 3D 生成的创业公司会被吃掉吗?
AI把考卷刷到接近满分,下一张,还能考什么?
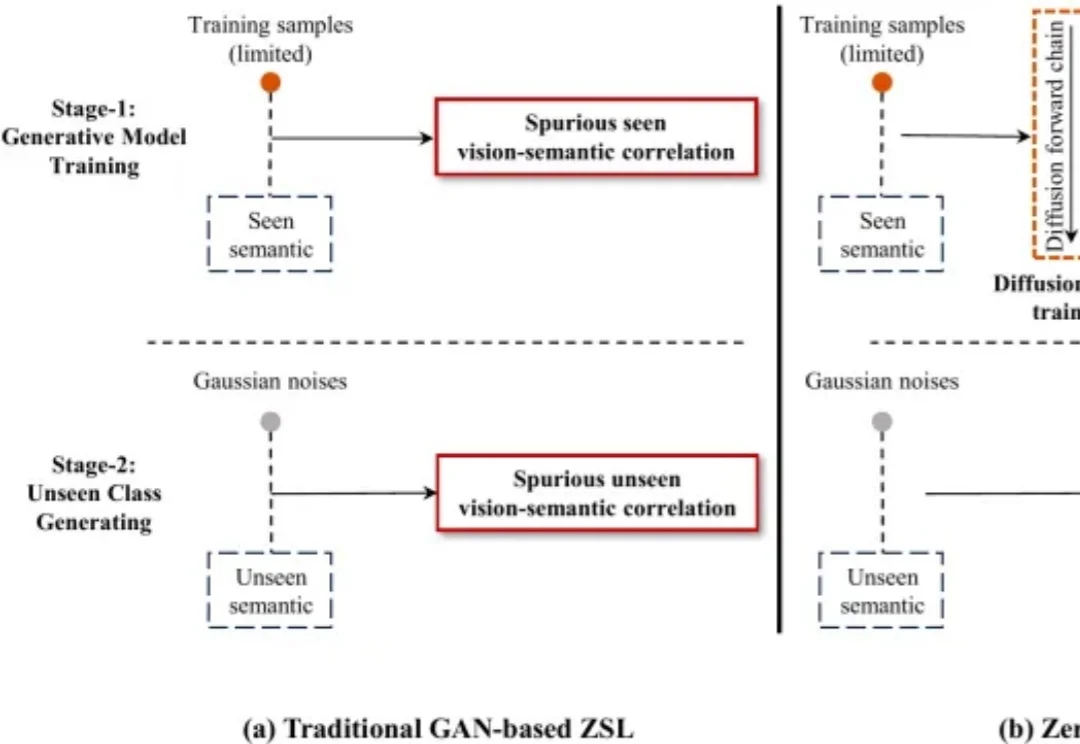
零样本学习的目标,是让模型识别训练时从未出现过的类别。
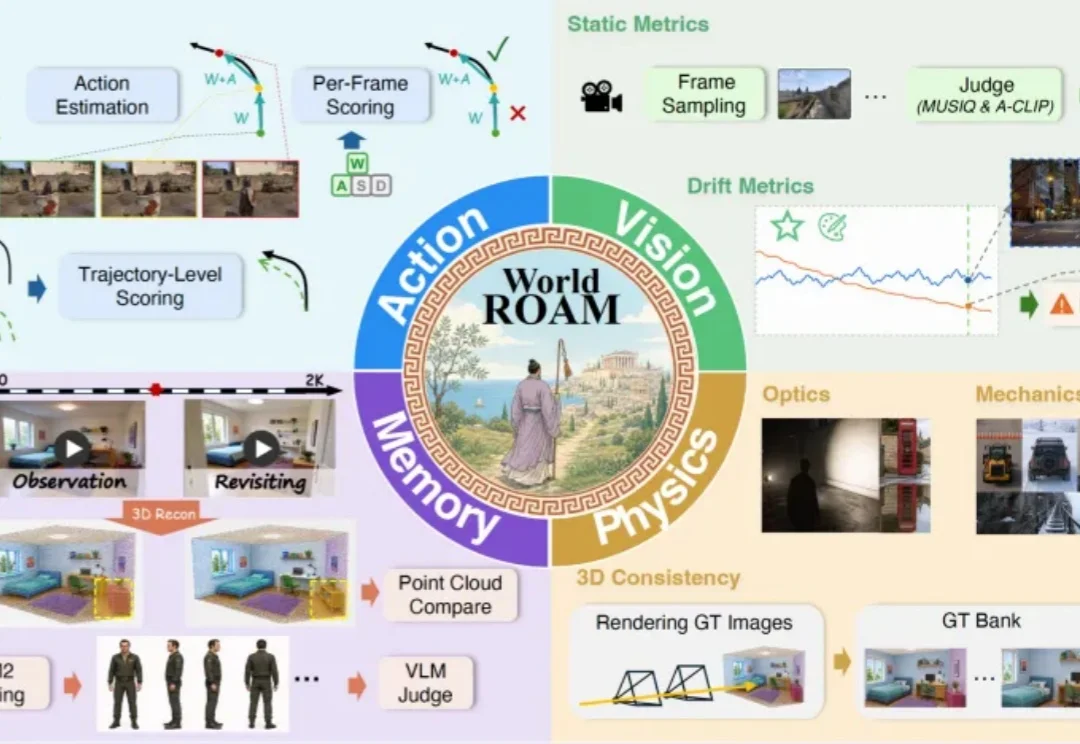
随着 Genie 3 的发布,可交互世界模型真正走到台前:用户不再只是观看生成视频,而是可以输入动作实时改变一个持续演化的世界。世界模型开始从「生成一段视频」走向「模拟一个可交互世界」,但能走进去,不等于经得起探索。模型能否持续响应控制、维持视觉与空间一致、遵守物理规律并记住来路,仍缺少系统评测。
地铁急刹,金属尖叫,广播响起「请乘客注意扶稳」,人群骚动、孩子哭声、对讲机杂音一层层涌上来···
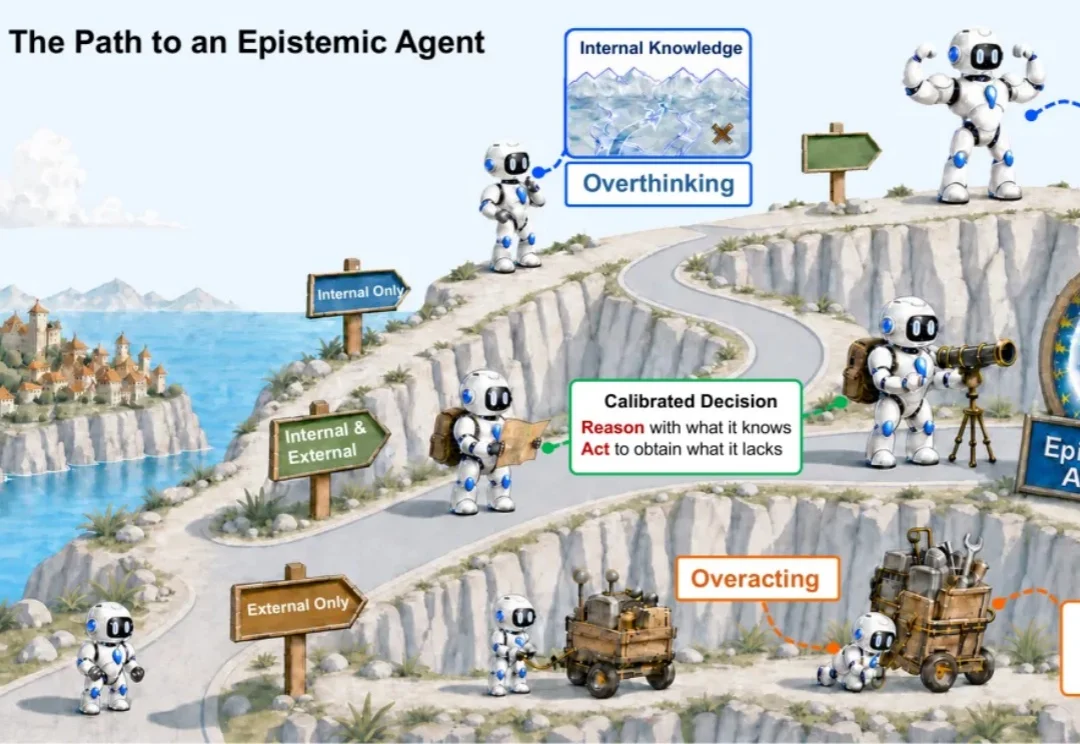
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。