突发!OpenAI官宣88小时突破NS方程千禧年难题
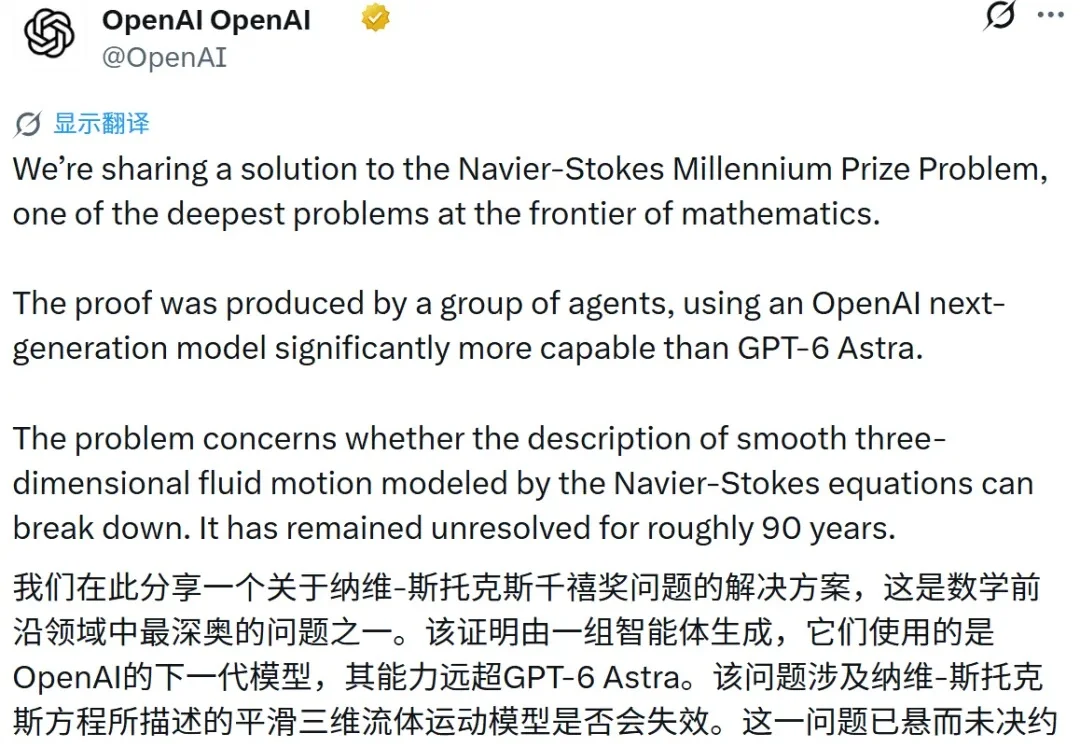
突发!OpenAI官宣88小时突破NS方程千禧年难题刚刚,OpenAI 发文投下一颗重磅新闻,称他们使用一种比 GPT-6 Astra 更强大的、未公开的下一代前沿大模型,联合约 10000 个并发协作的 AI Agent,仅耗时 88 个小时,便攻克了克雷数学研究所设立的七大千禧年难题之一 —— 纳维 - 斯托克斯方程(Navier-Stokes Equation)的存在性与光滑性问题。
搜索
刚刚,OpenAI 发文投下一颗重磅新闻,称他们使用一种比 GPT-6 Astra 更强大的、未公开的下一代前沿大模型,联合约 10000 个并发协作的 AI Agent,仅耗时 88 个小时,便攻克了克雷数学研究所设立的七大千禧年难题之一 —— 纳维 - 斯托克斯方程(Navier-Stokes Equation)的存在性与光滑性问题。
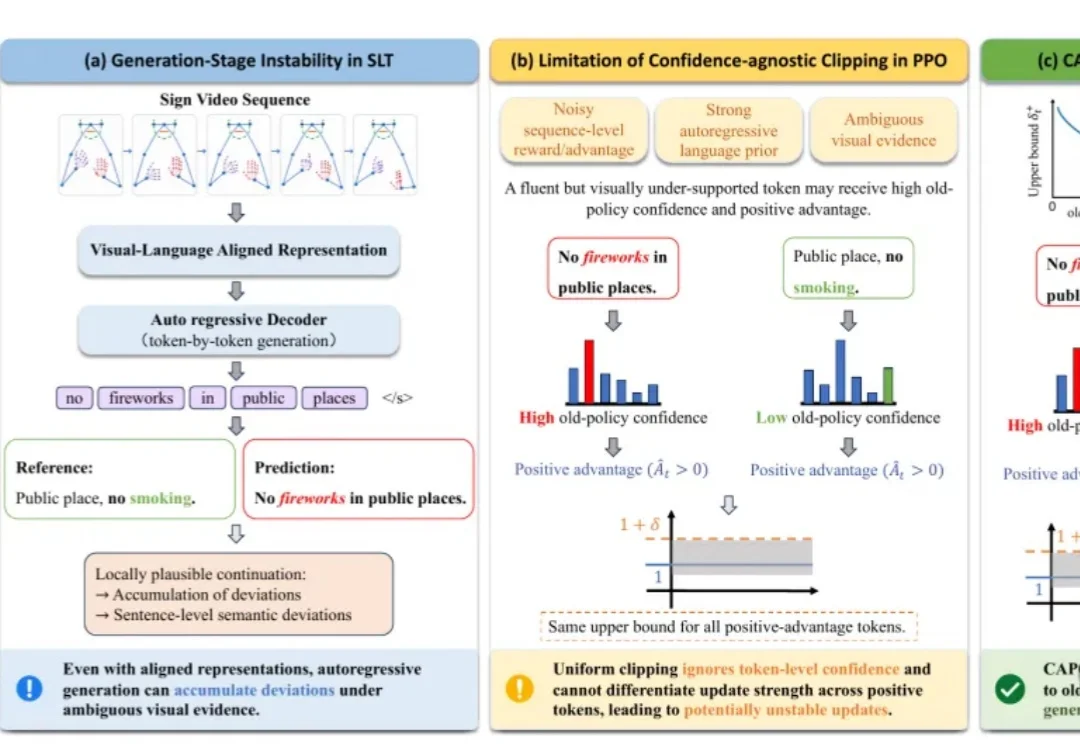
自动手语翻译中,一直存在一个隐蔽难题:模型即使已经较好地对齐了视觉与文本,也可能在逐词生成时,被某个局部合理、却缺少视觉证据支持的词带偏。
9月8日,DeepSeek Harness团队负责人崔添翼在社交平台放出约150个招聘名额,岗位涉及大模型研究平台方向、Agent框架组件方向、研发效率基建方向、数据工程方向等工程师。
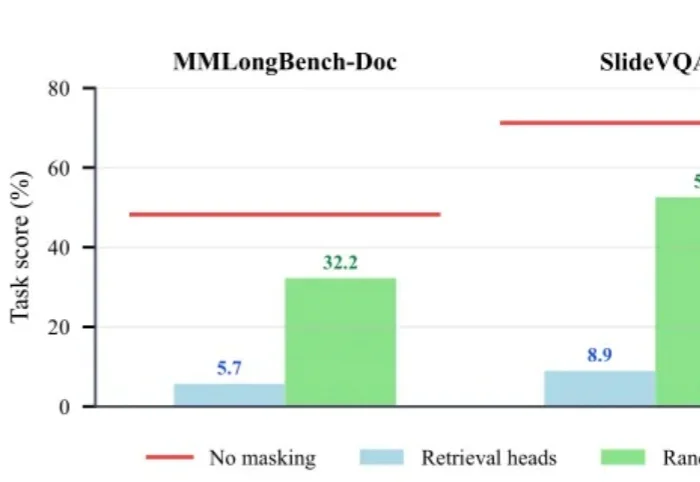
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
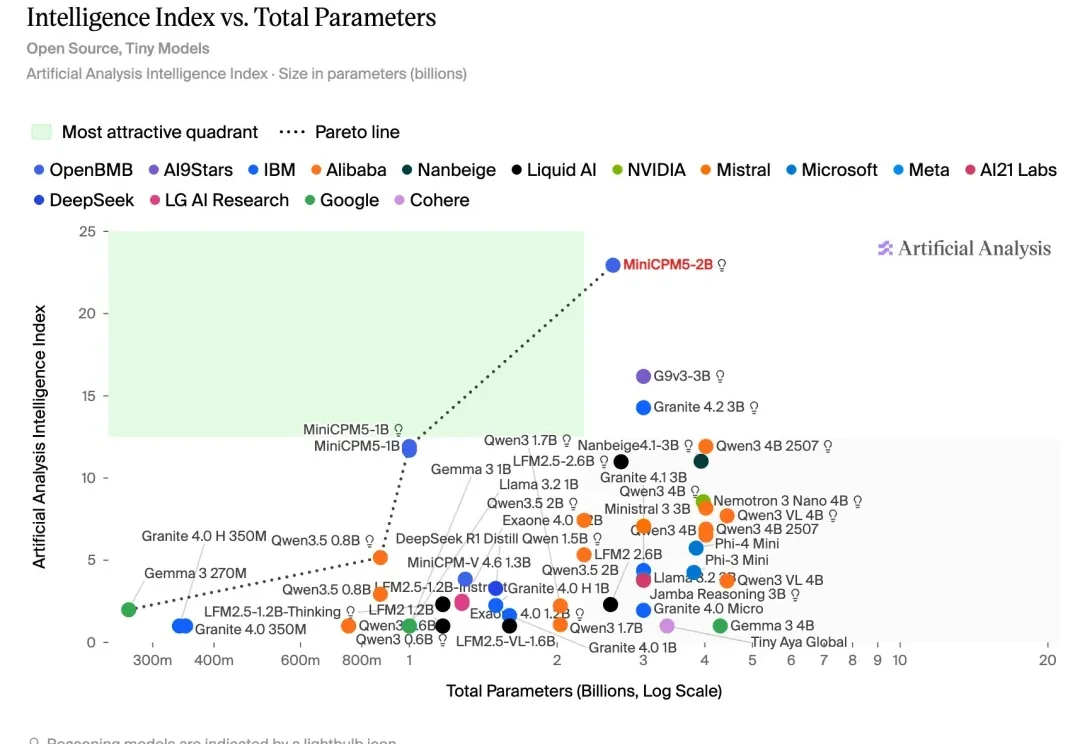
过去几年,端侧大模型一直在不断突破能力边界。
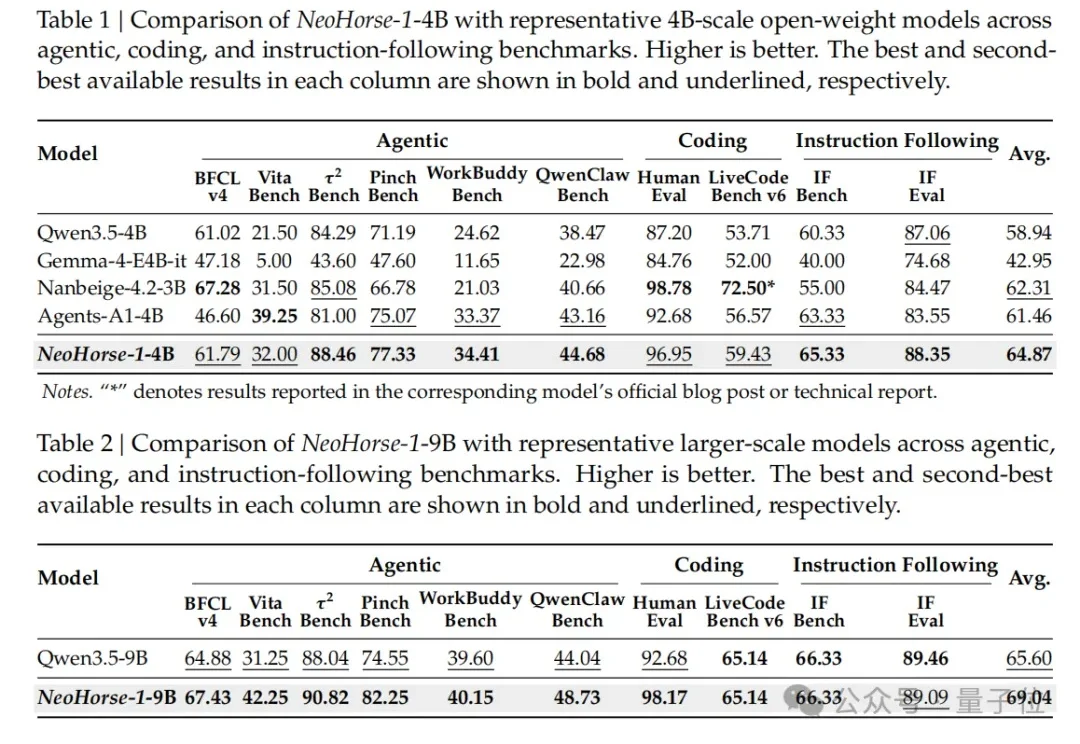
王云鹤创业后,首次交卷了大模型成果。
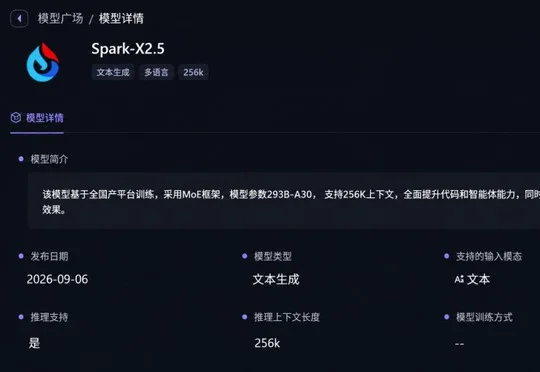
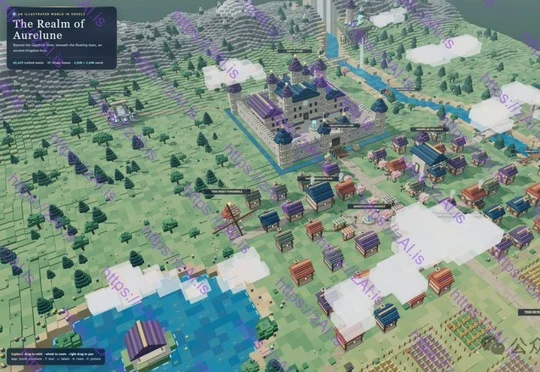
科大讯飞基于全国产算力发布2930亿参数的星火X2.5大模型,在代码、智能体、数学及理解等能力上有所提升,智东西通过游戏开发、3D创作、网页前端、数学推理和小说写作五项任务对其展开实测。
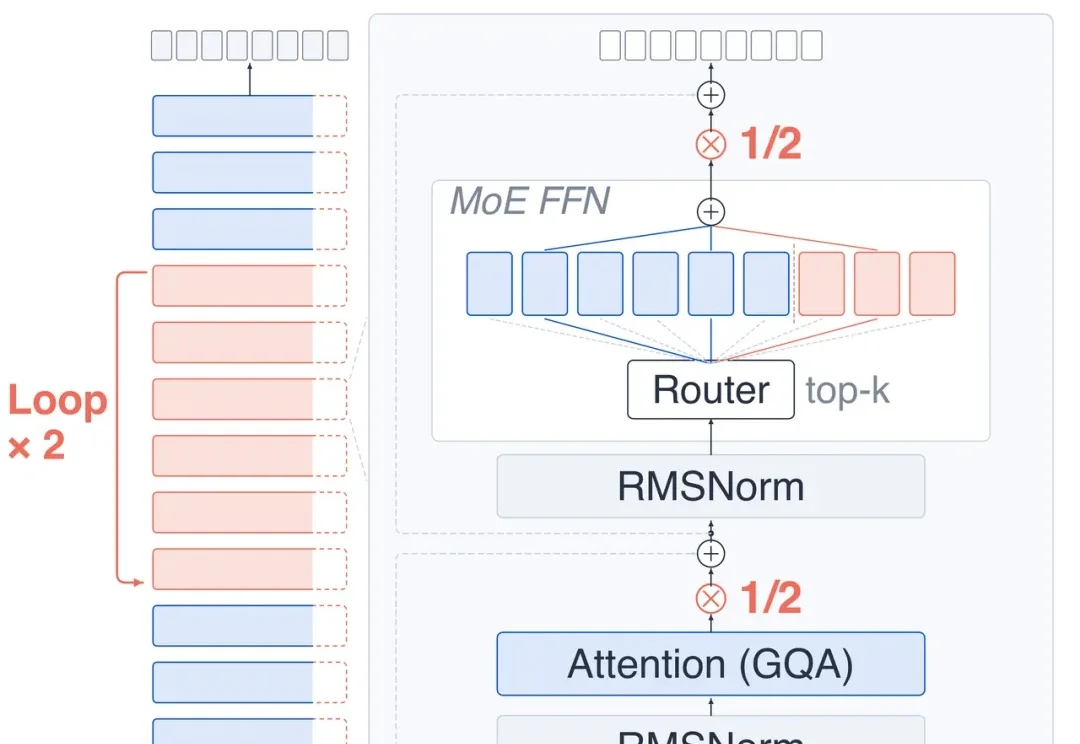
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。
OpenAI被曝正在内部测试GPT-6 Sol,单次速度约为GPT-6 Astra的6倍,同时公开内部数据称研究员每8小时工作日背后并行运行约3.1个Agent工作日、每日Agent推理资源花费超600美元,并宣布已实现"自动化AI研究实习生"目标;其首席科学家Jakub Pachocki同日发文警告AI对齐与监控难题,表示若必要OpenAI不排除单方面暂停扩大模型规模。
俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。