AI资讯新闻榜单内容搜索-transforme

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: transforme
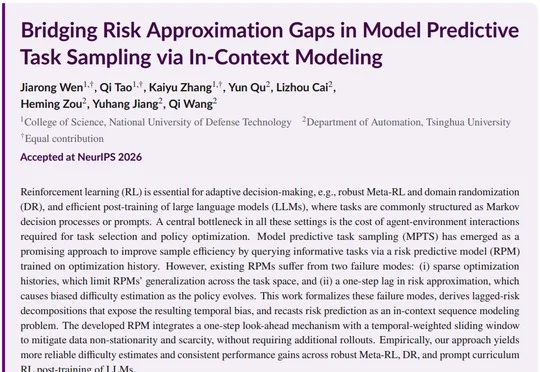
rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。

来自主题: AI技术研报
7390 点击    2026-11-06 15:51
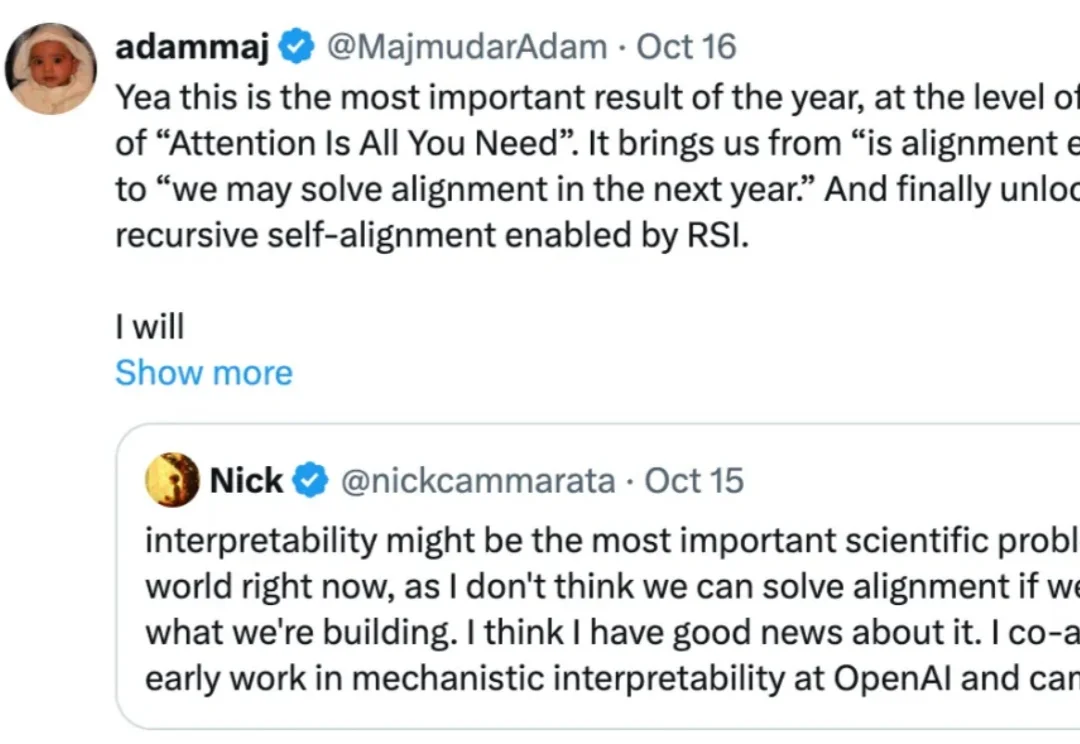
堪比Transformer奠基论文?这篇研究让AI圈吵起来了

堪比Transformer奠基论文?这篇研究让AI圈吵起来了

堪比Transformer奠基论文?这篇研究让AI圈吵起来了

这篇文章彻底颠覆了人工智能领域的认知,引发了广泛的猜测,Sam Altman 还公开表达了赞赏。

来自主题: AI资讯
10270 点击    2026-10-26 15:31
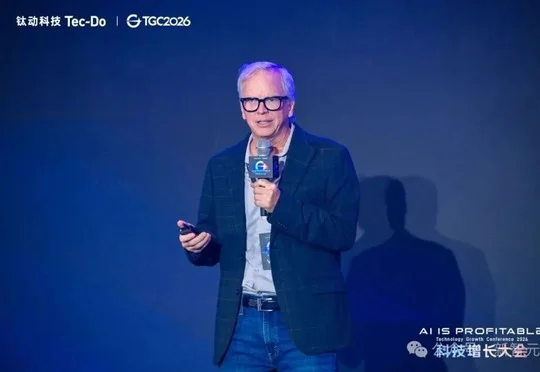
Transformer宗师空降中国!行业首个Pro Agent来了,中国队率先出手

Transformer宗师空降中国!行业首个Pro Agent来了,中国队率先出手

Transformer宗师空降中国!行业首个Pro Agent来了,中国队率先出手

钛动科技在广州TGC 2026科技增长大会发布行业首个Pro Agent Navos Pro,以专业、主动、盈利三项能力连接专业模型、数据与Agent Harness,推动AI for Work创造可衡量的商业回报。

来自主题: AI资讯
8320 点击    2026-10-24 13:45
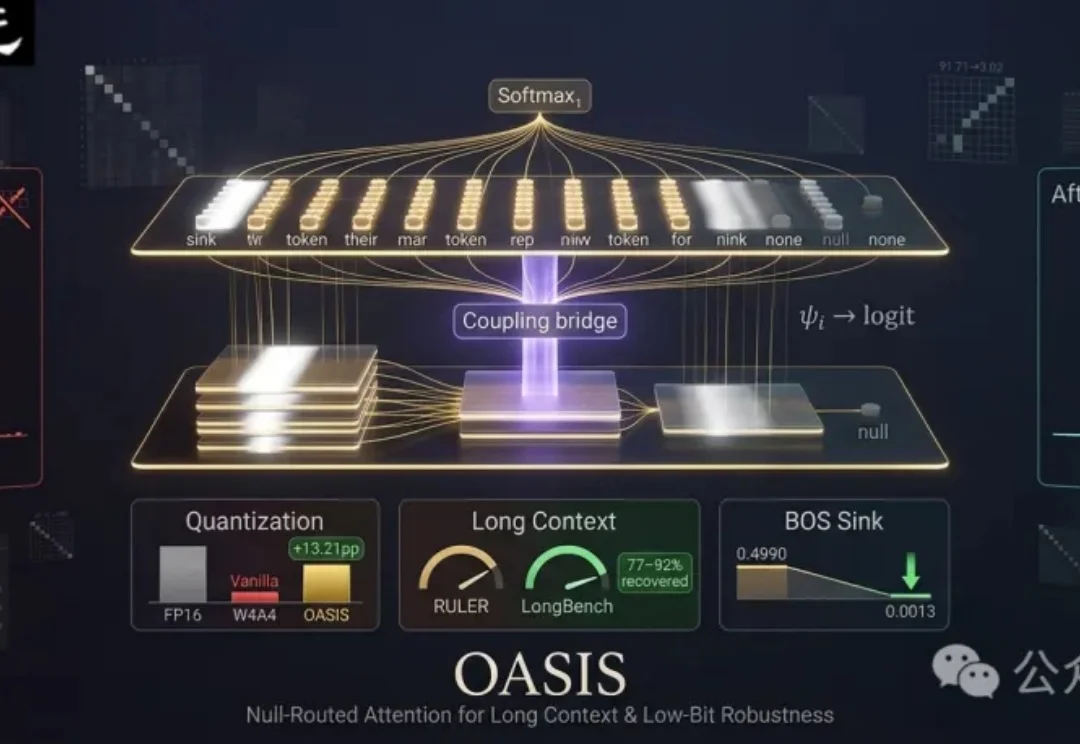
NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

NeurIPS'26 | 注意力也能弃权!改善长上下文、低比特鲁棒性

增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。

来自主题: AI技术研报
6278 点击    2026-10-23 09:51
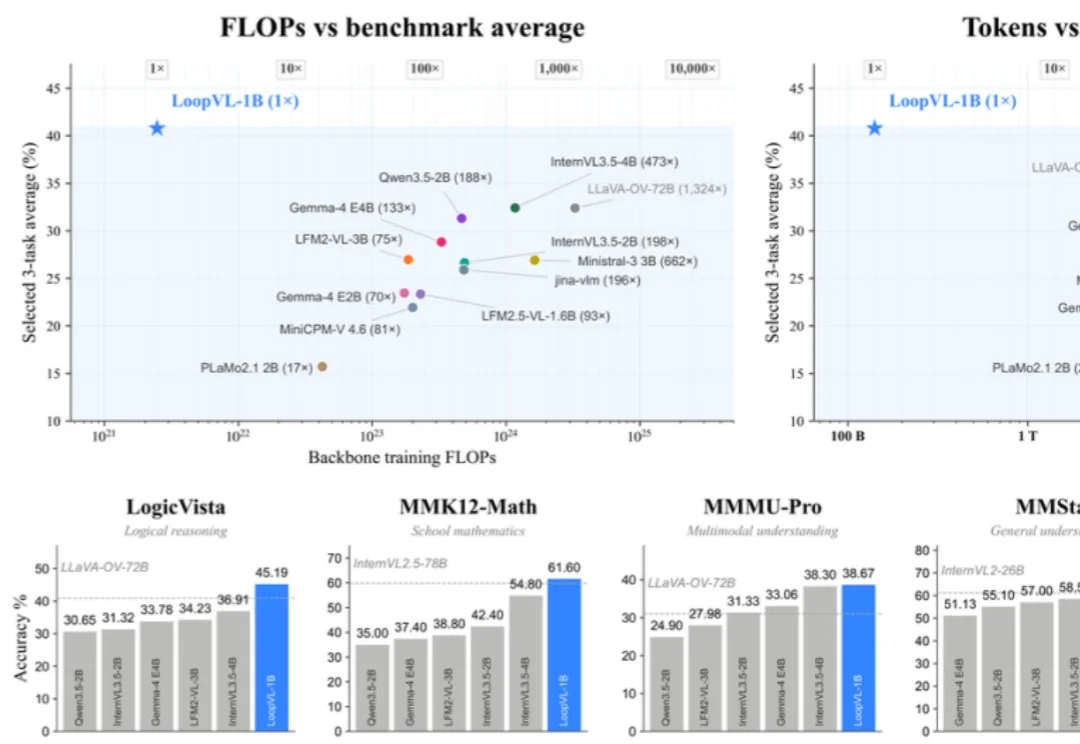
Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

Loop Transformer走向视觉语言模型,百度联合清华人大高瓴开源LoopVL

近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?

来自主题: AI技术研报
9116 点击    2026-10-20 11:24
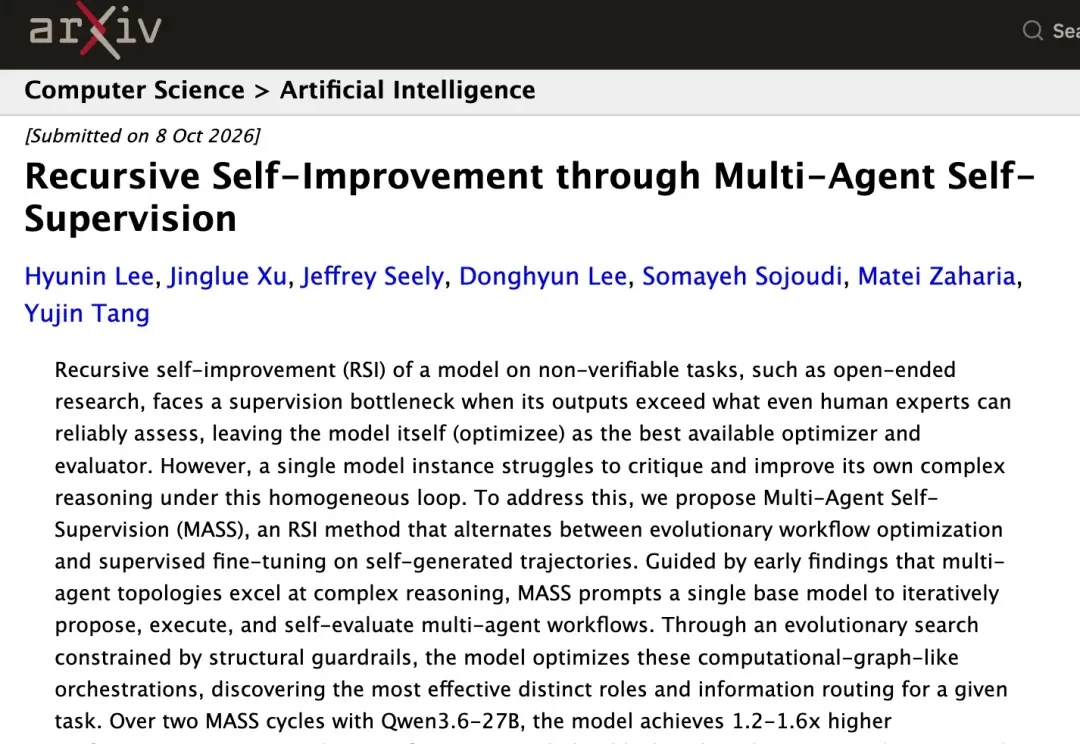
Transformer作者团队,下场RSI

Transformer作者团队,下场RSI

Transformer作者团队,下场RSI

由Transformer奠基论文核心作者Llion Jones创办的 Sakana AI,联手UC Berkeley带来了一项递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。

来自主题: AI技术研报
8214 点击    2026-10-19 12:25
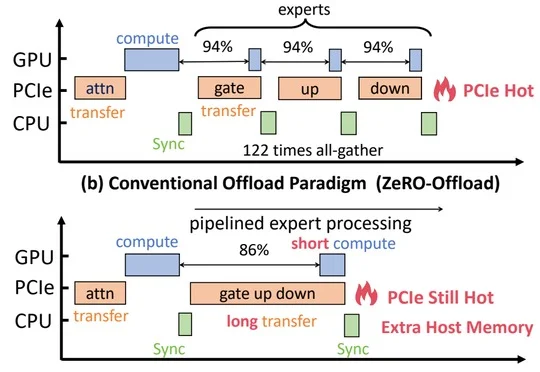
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算

别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算

别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算

清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。

来自主题: AI技术研报
10844 点击    2026-10-17 11:56
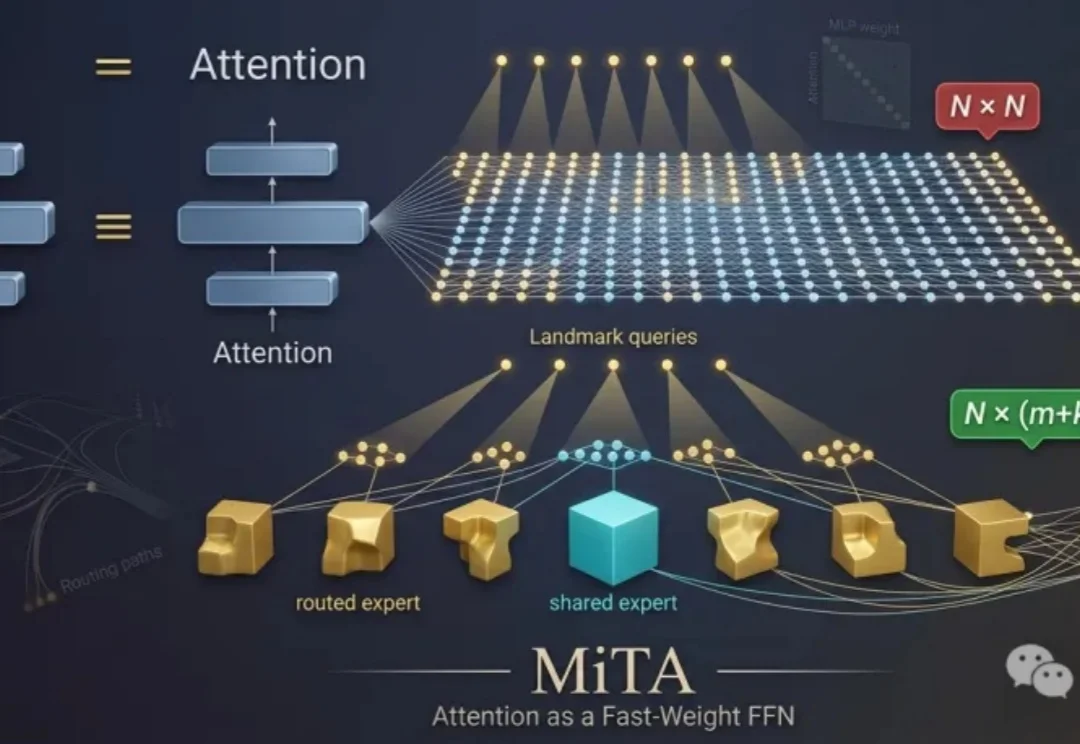
注意力也是FFN?从快权重出发,重新理解高效注意力 |NeurIPS'26

注意力也是FFN?从快权重出发,重新理解高效注意力 |NeurIPS'26

注意力也是FFN?从快权重出发,重新理解高效注意力 |NeurIPS'26

一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。

来自主题: AI技术研报
8797 点击    2026-10-12 11:45