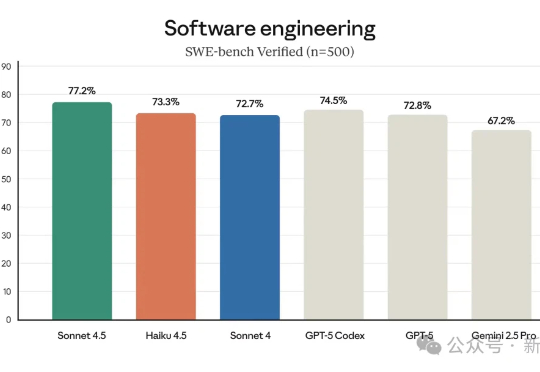
Anthropic深夜掀桌!5个月前顶配模型,现在价格只要1/3,速度还翻倍
Anthropic深夜掀桌!5个月前顶配模型,现在价格只要1/3,速度还翻倍Anthropic用Haiku 4.5打响了AI性价比之战!曾经的顶配性能,如今以三分之一的价格、两倍的速度下放,可以说是对高价AI模型的一次降维打击。
来自主题: AI资讯
9975 点击 2025-10-16 15:44

 搜索
Anthropic用Haiku 4.5打响了AI性价比之战!曾经的顶配性能,如今以三分之一的价格、两倍的速度下放,可以说是对高价AI模型的一次降维打击。
如果你曾将收据照片上传至报销系统,或在线阅读过PDF 格式的书籍,那么你可能已经使用过光学字符识别技术 ——这项已有数十年历史的技术能将打印体、手写体或印刷体文本图像转换为计算机可编辑的文本。
谷歌凌晨更新Veo 3.1,主打更强叙事与音频控制、首尾帧与多图参考等精控,接入Gemini API与Vertex AI,Flow与Gemini可用。可合成多人物场景、音画同步,片段最长约148秒;规格至1080p/24fps。
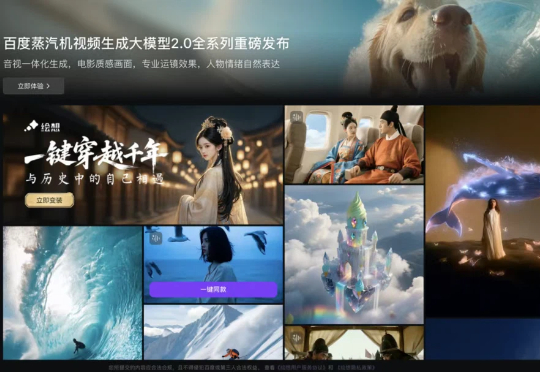
还在用Sora2做恶搞视频或表情包玩儿?快醒醒,国内AI视频玩家已实现弯道超车了—— 开卷实时流式生成!
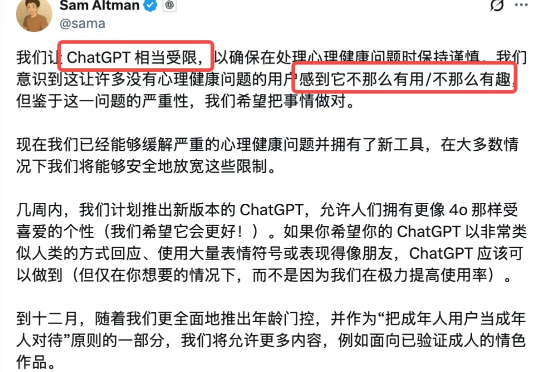
奥特曼宣布重新上线个性化、富有人味的的新ChatGPT版本,并将在12月份开放「成人模式」,OpenAI最终还是没忍住,要抄马斯克的Grok作业了~
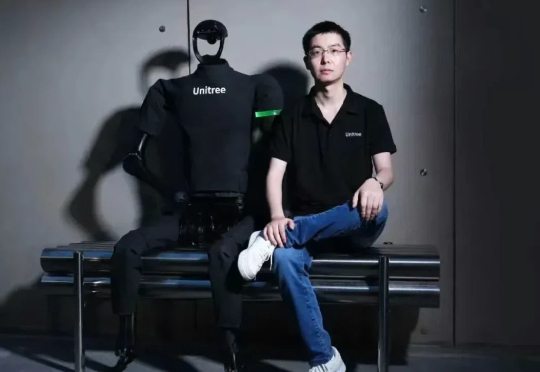
人火了是连毕业论文都要被翻出来的(doge)。 这不,宇树科技CEO王兴兴的硕士毕业论文就被网友们掘地三尺找到了。
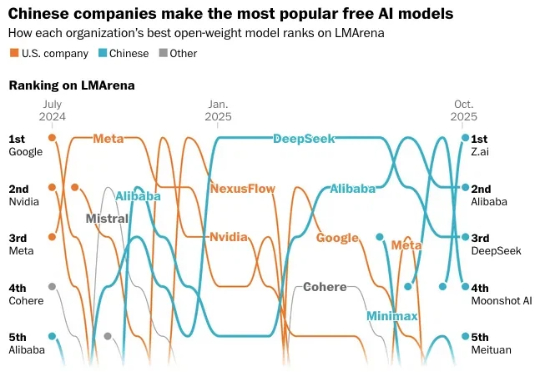
开源大模型,进入中国时间。 10月,公开数据显示,来自中国的开源大模型已经牢牢占据榜单前五。 阿里的Qwen系列和DeepSeek,更是从2024年下半年起,就在开源社区构建起越来越深远的影响力。
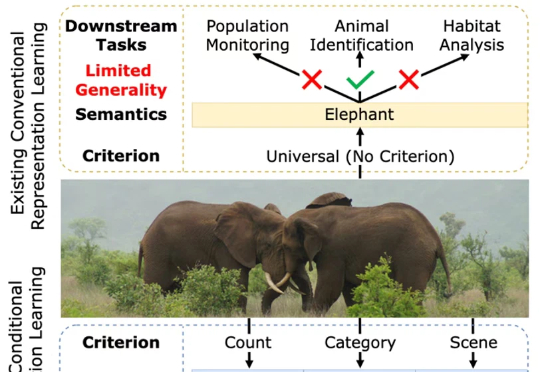
一张图片包含的信息是多维的。例如下面的图 1,我们至少可以得到三个层面的信息:主体是大象,数量有两头,环境是热带稀树草原(savanna)。然而,如果由传统的表征学习方法来处理这张图片,比方说就将其送入一个在 ImageNet 上训练好的 ResNet 或者 Vision Transformer,往往得到的表征只会体现其主体信息,也就是会简单地将该图片归为大象这一类别。这显然是不合理的。
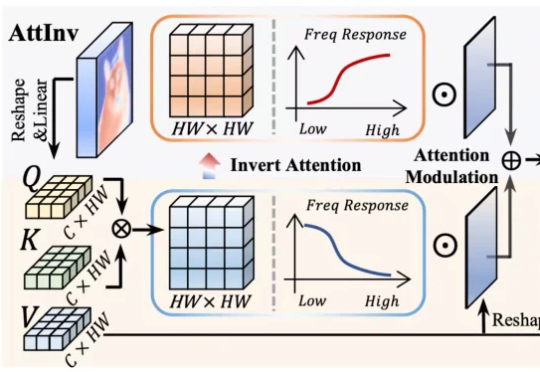
针对视觉 Transformer(ViT)因其固有 “低通滤波” 特性导致深度网络中细节信息丢失的问题,我们提出了一种即插即用、受电路理论启发的 频率动态注意力调制(FDAM)模块。它通过巧妙地 “反转” 注意力以生成高频补偿,并对特征频谱进行动态缩放,最终在几乎不增加计算成本的情况下,大幅提升了模型在分割、检测等密集预测任务上的性能,并取得了 SOTA 效果。
近日,RoboChallenge 重磅推出!这是全球首个大规模、多任务的在真实物理环境中由真实机器人执行操作任务的基准测试。