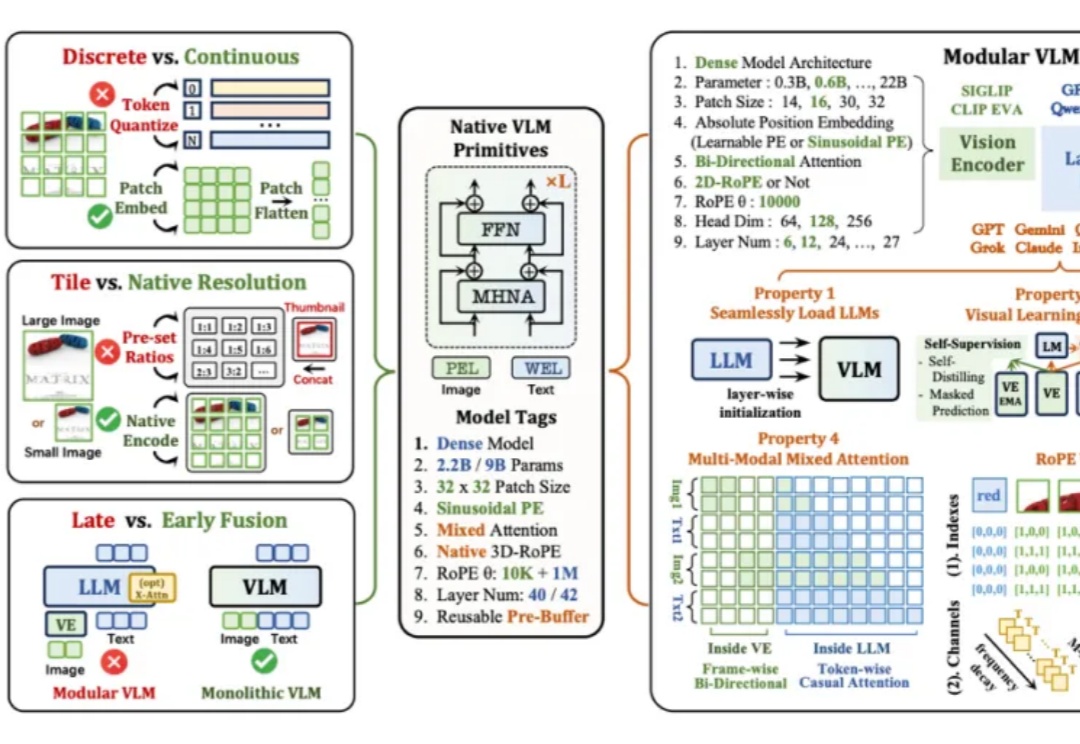
高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型
高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型当下主流的视觉语言模型(Vision-Language Models, VLM),通常都采用这样一种设计思路:将预训练的视觉编码器与大语言模型通过投影层拼接起来。这种模块化架构成就了当前 VLM 的辉煌,但也带来了一系列新的问题——多阶段训练复杂、组件间语义对齐成本高,不同模块的扩展规律难以协调。
搜索
当下主流的视觉语言模型(Vision-Language Models, VLM),通常都采用这样一种设计思路:将预训练的视觉编码器与大语言模型通过投影层拼接起来。这种模块化架构成就了当前 VLM 的辉煌,但也带来了一系列新的问题——多阶段训练复杂、组件间语义对齐成本高,不同模块的扩展规律难以协调。
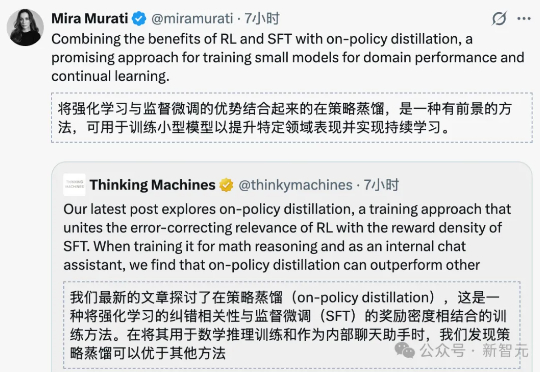
今天要讲的On-Policy Distillation(同策略/在线策略蒸馏)。这是一个Thinking Machines整的新活,这个新策略既有强化学习等在线策略方法的相关性和可靠性;又具备离线策略(Off-policy)方法的数据效率。
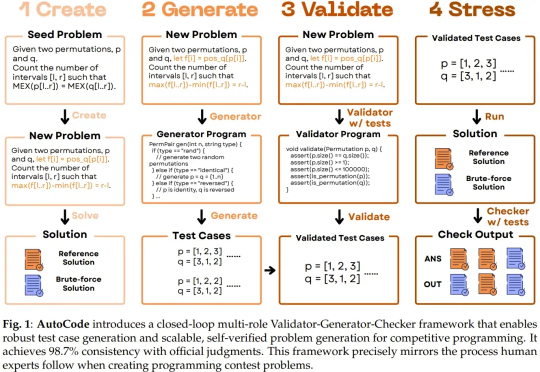
在当前评测生成式模型代码能力的浪潮中,传统依赖人工编写的算法基准测试集,正日益暴露出可扩展性不足与数据污染严重两大瓶颈。
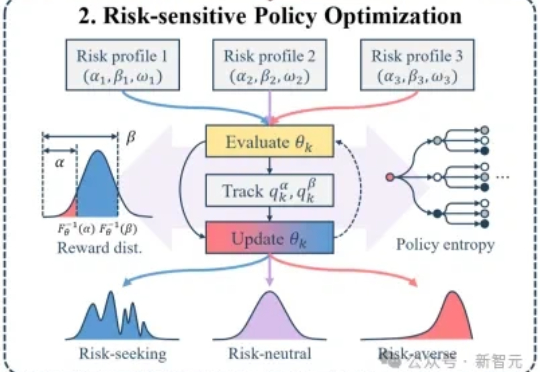
大模型后训练的痛点:均值优化忽略低概率高信息路径,导致推理能力停滞。RiskPO双管齐下,MVaR目标函数推导梯度估计,多问题捆绑转化反馈,实验中Geo3K准确率54.5%,LiveCodeBench Pass@1提升1%,泛化能力强悍。
大家好,我是袋鼠帝。 国庆那几天,刷抖音,偶然刷到了一个看起来挺🐂🍺的AI工具。 视频里,一个哥们只是发布了一个任务,Agent就自动打开了小红书网站,登录账号,上传图片,写入标题和笔记内容,最后自己
AI编程领域竞争正酣。就在DeepSeek、阿里、Google、OpenAI等巨头纷纷展示最新代码生成能力之际,快手也交出了一份重量级答卷——发布AI编程产品矩阵,正式宣布进军AI Coding赛道。
复旦大学NLP实验室研发Game-RL,利用游戏丰富视觉元素和明确规则生成多模态可验证推理数据,通过强化训练提升视觉语言模型的推理能力。创新性地提出Code2Logic方法,系统化合成游戏任务数据,构建GameQA数据集,验证了游戏数据在复杂推理训练中的优势。
今天凌晨,Anthropic 上线了「Claude Code on the web」(即网页版 Claude Code)功能,这种全新的方式可以让用户直接从浏览器中委派编程任务。目前,网页版 Claude Code 处于 Beta 阶段,作为研究预览版向 Pro 和 Max 用户开放使用。
随着大型语言模型(LLM)朝着通用能力迈进,并以通用人工智能(AGI)为最终目标,测试其生成问题的能力也正变得越来越重要。尤其是在将 LLM 应用于高级编程任务时,因为未来 LLM 编程能力的发展和经济整合将需要大量的验证工作。
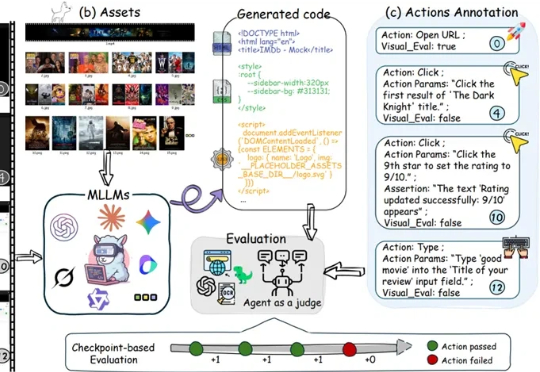
多模态大模型在根据静态截图生成网页代码(Image-to-Code)方面已展现出不俗能力,这让许多人对AI自动化前端开发充满期待。