北航领衔发布300页代码智能综述:从基础模型到智能体,一次读懂Code LLM全景图
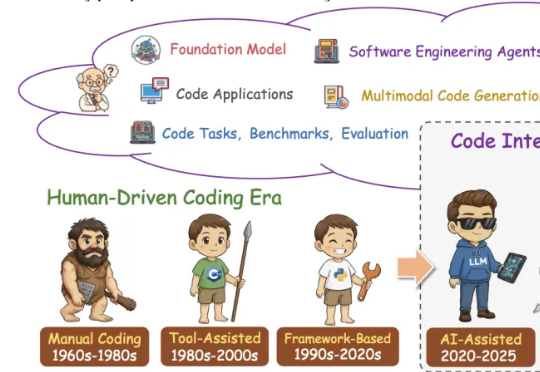
北航领衔发布300页代码智能综述:从基础模型到智能体,一次读懂Code LLM全景图这篇学术论长文由北京航空航天大学复杂关键软件环境全国重点实验室领衔。《From Code Foundation Models to Agents and Applications》一文是对过去几年代码智能领域的一次系统梳理:模型、任务、训练、智能体、安全与应用都被串联成了一条完整、连贯的技术链路。
搜索
这篇学术论长文由北京航空航天大学复杂关键软件环境全国重点实验室领衔。《From Code Foundation Models to Agents and Applications》一文是对过去几年代码智能领域的一次系统梳理:模型、任务、训练、智能体、安全与应用都被串联成了一条完整、连贯的技术链路。
来自中国的初创团队词元无限给出了自己的答案。由清华姚班校友带队设计开发的编码智能体 InfCode,在 SWE-Bench Verified 和 Multi-SWE-bench-CPP 两项非常权威的 AI Coding 基准中双双登顶,力压一众编程智能体。
这篇论文由北京航空航天大学、阿里巴巴、字节跳动、上海人工智能实验室等几十家顶尖机构联合撰写,全文长达303页,是对当前“代码大模型(Code LLMs)”领域最详尽的百科全书式指南。
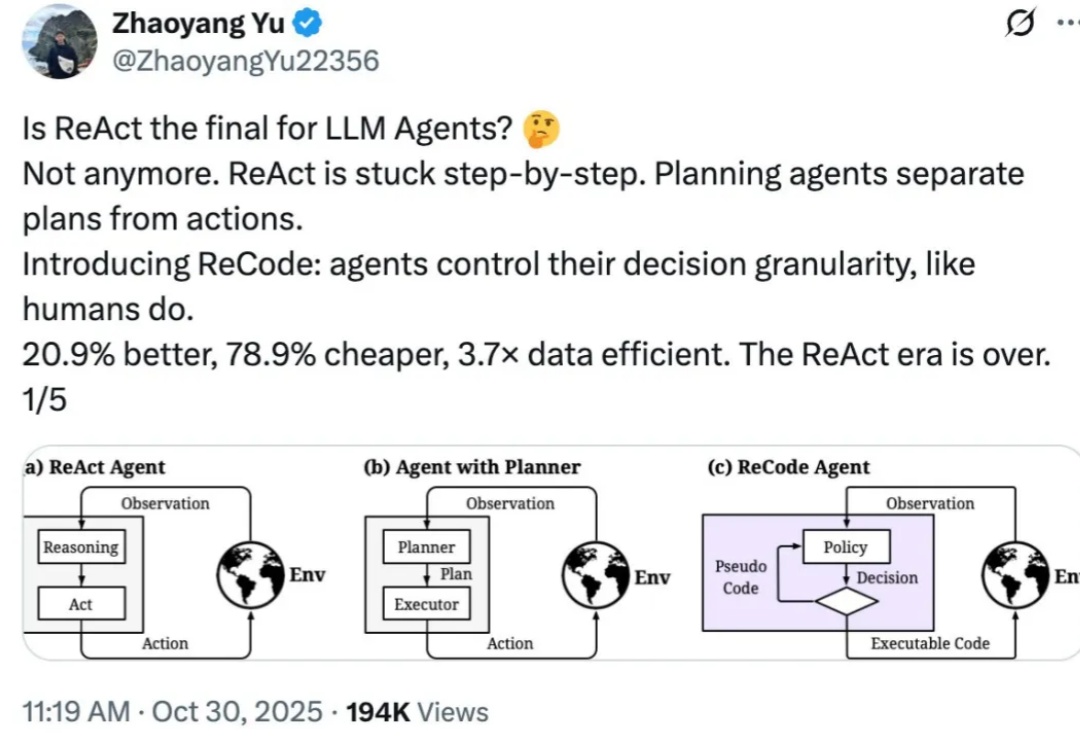
想象你在准备早餐:你不会先写一份详细到「左手抓鸡蛋、右手拿碗、手腕旋转 45 度敲击蛋壳」这样的清单,也不会只有一个笼统的计划叫「做个早餐」,然后不知所措。
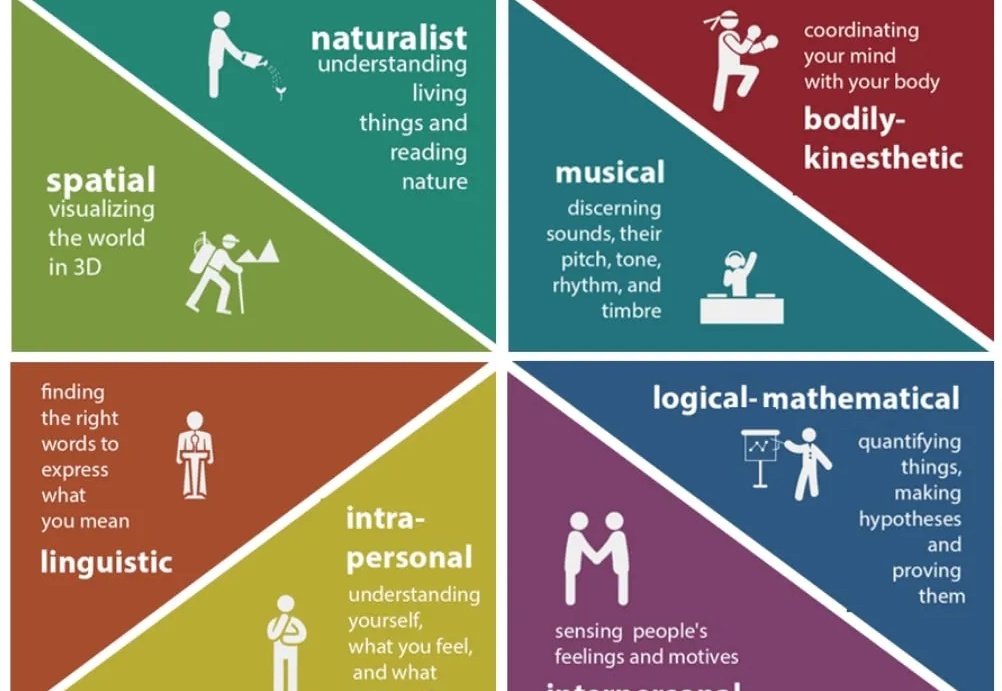
如今 LLM 的语言理解与生成能力已展现出惊人的广泛适用性,但随着 LLM 的发展,一个事实越发凸显:仅靠语言,仍不足以支撑真正的智能。
当地时间 12 月 2 日,Anthropic 宣布收购了热门开发者工具初创公司 Bun。这项交易的财务条款尚不清楚,但它标志着 Anthropic 向开发者工具领域迈出了重要一步。
在 Vision-Language Model 领域,提升其复杂推理能力通常依赖于耗费巨大的人工标注数据或启发式奖励。这不仅成本高昂,且难以规模化。
这是一篇报告解读,原文是《DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models》
随着大语言模型(LLM)的商业价值快速提升,其昂贵的训练成本使得模型版权保护(IP Protection)成为业界关注的焦点。然而,现有模型版权验证手段(如模型指纹)往往忽略一个关键威胁:攻击者一旦直接窃取模型权重,即拥有对模型的完全控制权,能够逆向指纹 / 水印,或通过修改输出内容绕过指纹验证。
在架构层面,Milvus 2.6 大幅简化系统架构,整合多个核心组件 —— 例如将原有的 Coordinator 组件(含 RootCoord、QueryCoord、DataCoord)统一整合为 MixCoord,并将 IndexNode 与 DataNode 合并为单一组件。这些调整不仅降低了系统复杂度,更显著提升了系统的可维护性与横向扩展性。