刚刚,中国AI闯入全球编程前二!前面只剩Claude
刚刚,中国AI闯入全球编程前二!前面只剩ClaudeCode Arena最新放榜,Qwen3.7-Max以1541分冲进全球第四,成为前五中唯一的非Claude模型。编程,中国模型第一次杀到这个位置。
来自主题: AI技术研报
11855 点击 2026-05-27 09:14

 搜索
Code Arena最新放榜,Qwen3.7-Max以1541分冲进全球第四,成为前五中唯一的非Claude模型。编程,中国模型第一次杀到这个位置。
说在前面:这又是一篇讲Harness的Survey,你最近可能已经看过了数篇讲Harness的文章、论文,其中还可能包括我上周解读的《Agent Harness Engineering:Agent的底盘工程综述|CMU、耶鲁、Amazon》。
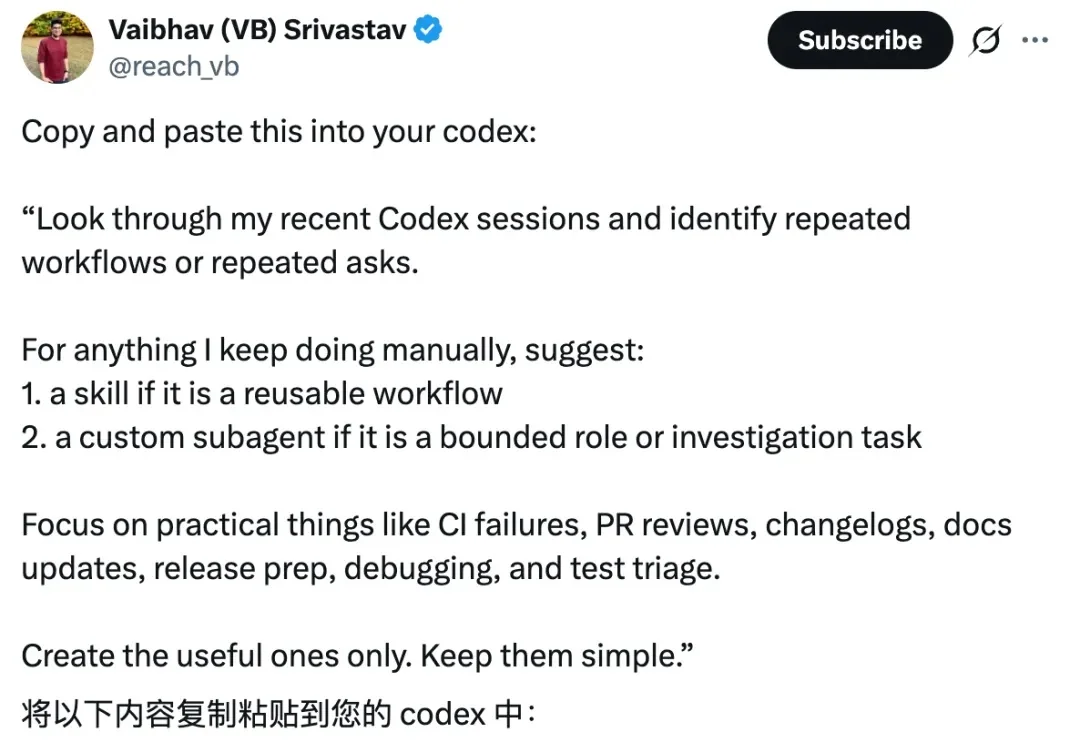
Codex自家程序员,直接把Codex「自我蒸馏」的秘籍给爆出来了…
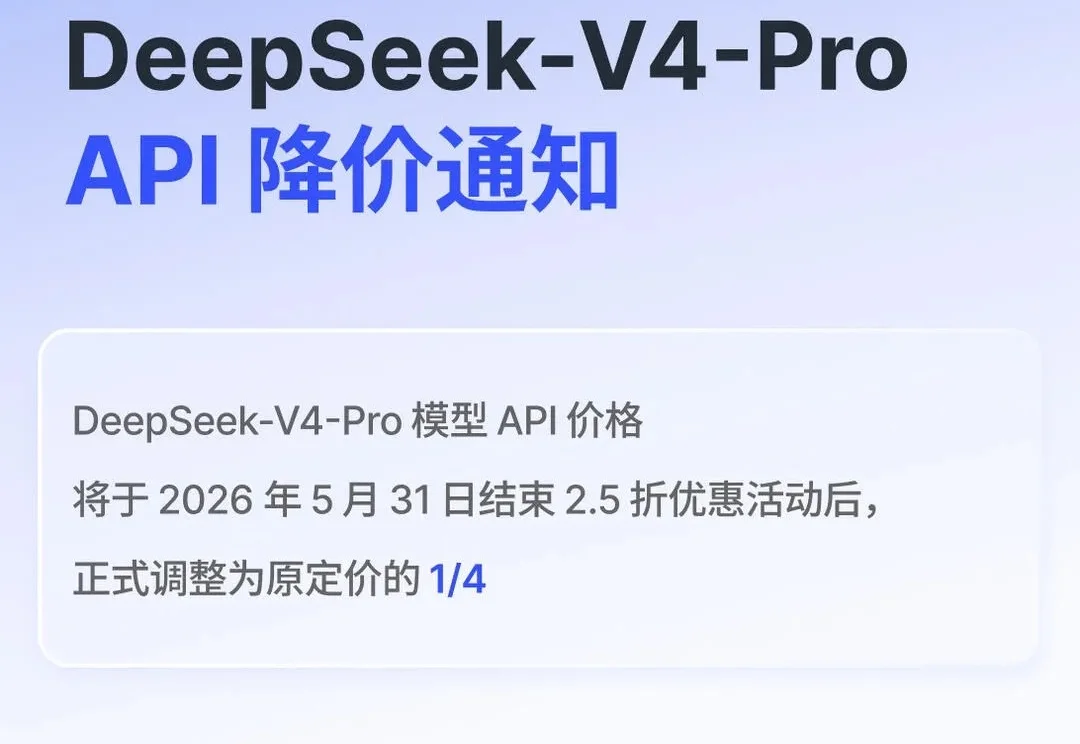
DeepSeek 之于大模型,就像蜜雪冰城之于奶茶。你不必纠结性价比,因为它的本事你挑不出毛病,你的钱包它也从不为难。
即将结束博士生涯的童晟邦,正站在另一个起点上。
大家好,我是袋鼠帝。 数字员工、团队这些概念其实已经出来很久了。
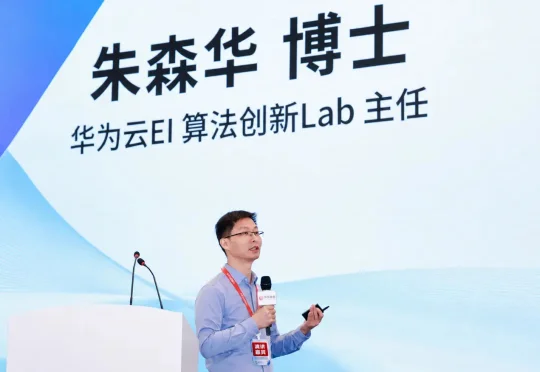
刚刚完成新一轮亿元融资的具脑磐石,从成立之初押注的正是这个方向。具脑磐石由朱森华创立。他曾任华为云AI算法创新Lab主任,主导过AI脑科学云平台、盘古具身大模型、全球具身智能产业创新中心等系统级项目。在业内,他被称为“华为具身大脑一号位”。
Claude Code 的 settings.json 里有 125 个配置键。官方文档只讲了大约 40 个。
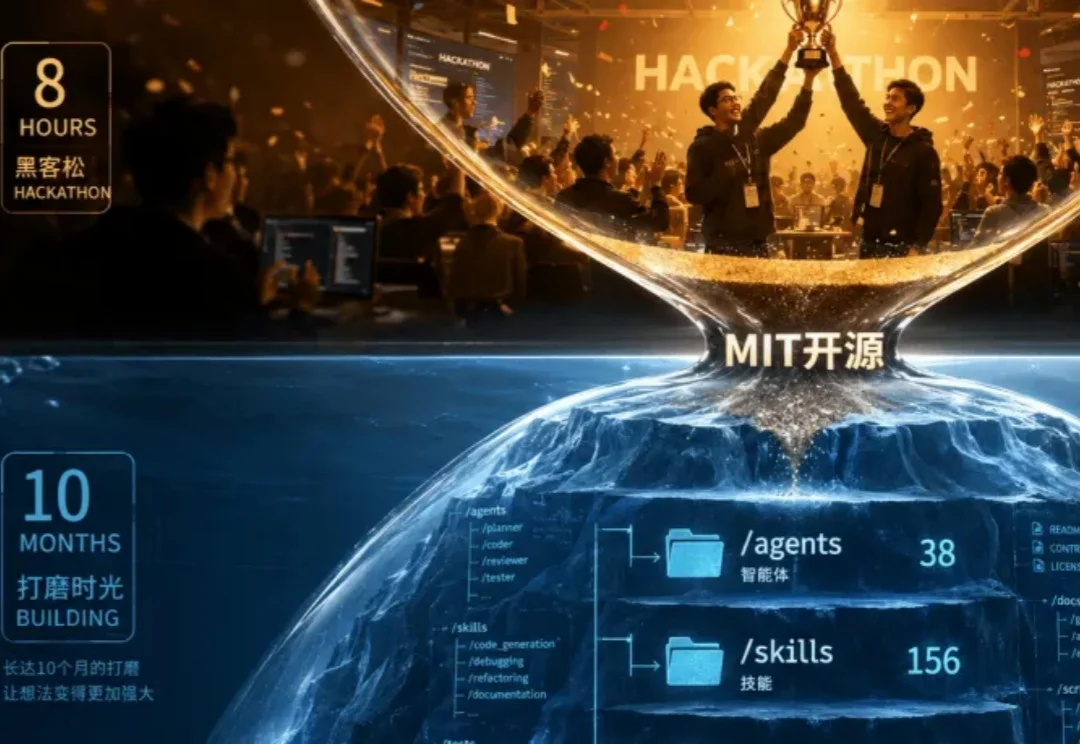
旧金山开发者Affaan Mustafa把Claude Code打磨成38个专业智能体、156项技能的超级系统,开源后短短时间冲上GitHub 15万星!
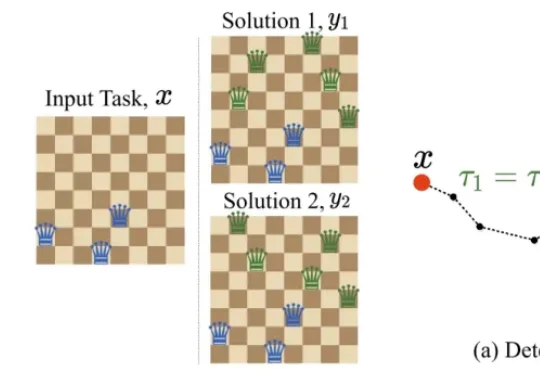
现在,图灵奖得主 Yoshua Bengio 给出了一份全新的并行方案。他们提出了 GRAM(Generative Recursive reAsoning Models,生成式递归推理模型),把确定性的递归潜在推理变成了概率性的多轨迹计算。模型在潜在空间中进行随机递归推理,每一步都可以采样不同的方向,最终形成对解空间的多路径探索。