GRPO遭遇瓶颈?G²RPO-A让自适应指导为小模型推理能力「开外挂」
GRPO遭遇瓶颈?G²RPO-A让自适应指导为小模型推理能力「开外挂」大模型时代的「炼金术师」们,或许都曾面临一个共同的困扰:当我们试图将 DeepSeek-R1、OpenAI-o1 那种惊艳的推理能力迁移到小规模语言模型(SLMs)时,效果却总是差强人意。现有的强化学习方法如 GRPO 在 7B+ 的大模型上效果显著,但一旦应用到 1.7B 甚至更小参数的模型上,性能提升就微乎其微。
搜索
大模型时代的「炼金术师」们,或许都曾面临一个共同的困扰:当我们试图将 DeepSeek-R1、OpenAI-o1 那种惊艳的推理能力迁移到小规模语言模型(SLMs)时,效果却总是差强人意。现有的强化学习方法如 GRPO 在 7B+ 的大模型上效果显著,但一旦应用到 1.7B 甚至更小参数的模型上,性能提升就微乎其微。
据金融时报的最新消息,多家机构目前正寻求领投 DeepSeek 的首轮融资。如果谈判顺利,DeepSeek 在本轮的估值将达到约 450 亿美元。短短几周内,DeepSeek 的估值就从刚开始被爆料的 200 亿美元一路狂飙翻倍。
AI最好的用途,是改善人类健康。 如果真正把这项技术用在科学和医学上,它不仅能解决今天最难的研究问题,也会打开药物发现和疾病理解的一整串下游可能性。
感谢鲸鱼兄弟开源。
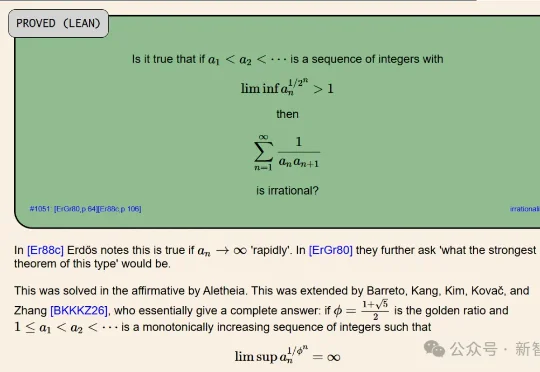
Google DeepMind再次血洗数学圈!700个地狱级难题被丢进Gemini的熔炉,结果让数学家集体破防:这哪是证明,这分明是「逻辑拆迁」。DeepMind这一波不仅贴脸爆杀了OpenAI,还砸烂了人类所有的优越感。
吴恩达老师又出新课了。5月1号刚刚上线的这次教的是提示词。课程名叫 AI Prompting for Everyone,在 DeepLearning.AI 平台上线,由吴恩达本人主讲,面向所有人,不需要任何技术背景。
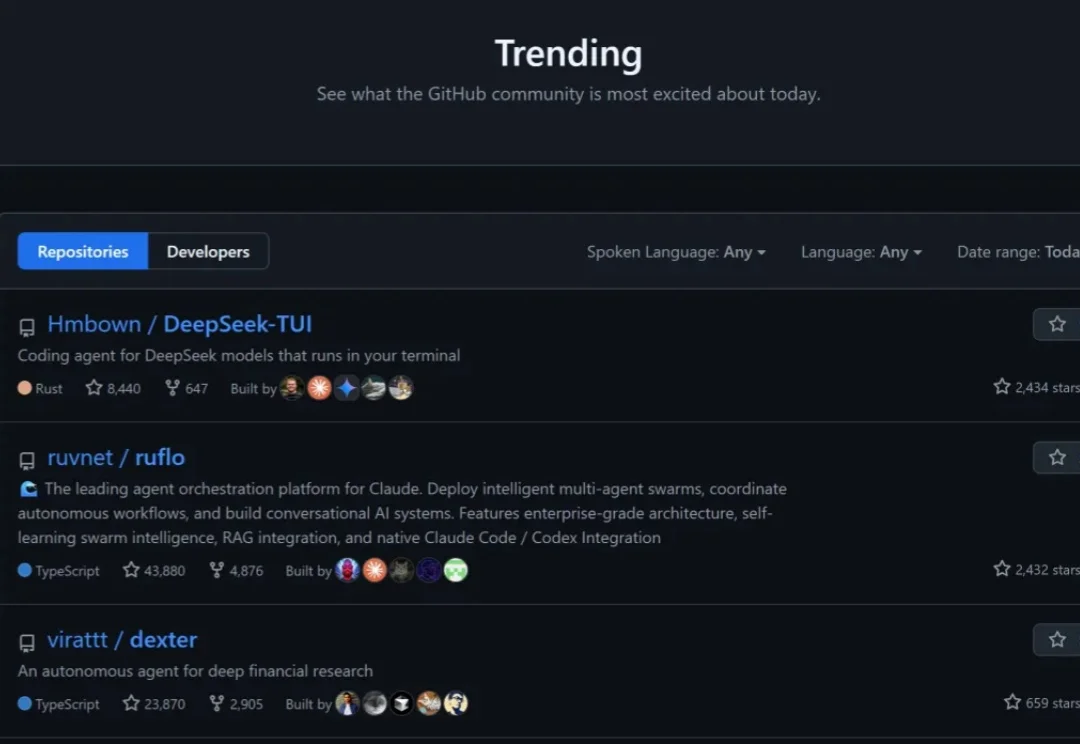
DeepSeek也有自己专属的Coding Agent了。名字简单粗暴,就叫DeepSeek-TUI,作者自称是一名“鲸鱼兄弟”的DeepSeek爱好者。刚刚,这个项目的星标数突然开始骤增,来到了2.3k,还登上了GitHub热榜。
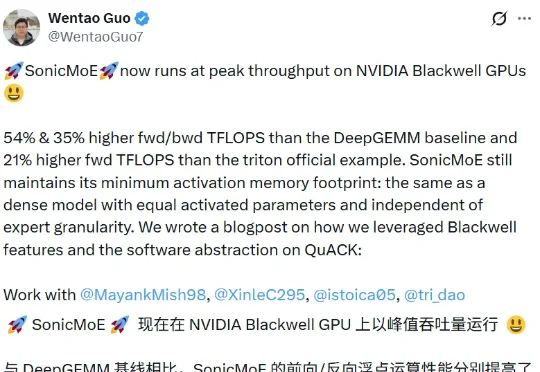
近日,由普林斯顿大学 Tri Dao(FlashAttention 的一作)和加州大学伯克利分校 Ion Stoica 领导的一个联合研究团队也做出了一个超快的索尼克:SonicMoE。据介绍,SonicMoE 能在英伟达 Blackwell GPU 上以峰值吞吐量运行!并且运算性能超过了 DeepSeek 之前开源并引发巨大轰动的 DeepGEMM。
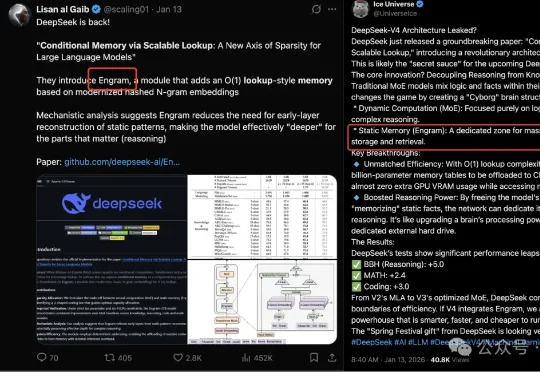
DeepSeekV4的技术报告里有mHC,有CSA,有HCA,有Muon,有FP4……唯独没有Engram。Engram在今年1月由DeepSeek和北大联合开源,主要研究大模型的记忆与效率问题。
上周太集中发的后果就是光在用GPT -5.5了,小米的Mimo-V2.5-Pro,DeepSeek V4 Pro还没有放在Agent的场景上测。所以我跟钱包一拍即合,复制了4个一模一样的Hermes Agent,记忆一样,skill一样,系统设置一样,能调用的工具也一样。