
“相比写Python,我的工程师更愿意造Agent”,黄仁勋最新26分钟对话:未来公司将建立在Harness之上
“相比写Python,我的工程师更愿意造Agent”,黄仁勋最新26分钟对话:未来公司将建立在Harness之上“当你需要增强自己的智能时,别指望给第三方打个电话解决,而应该在公司内部完成。”
来自主题: AI资讯
10633 点击 2026-07-14 11:39

 搜索
“当你需要增强自己的智能时,别指望给第三方打个电话解决,而应该在公司内部完成。”
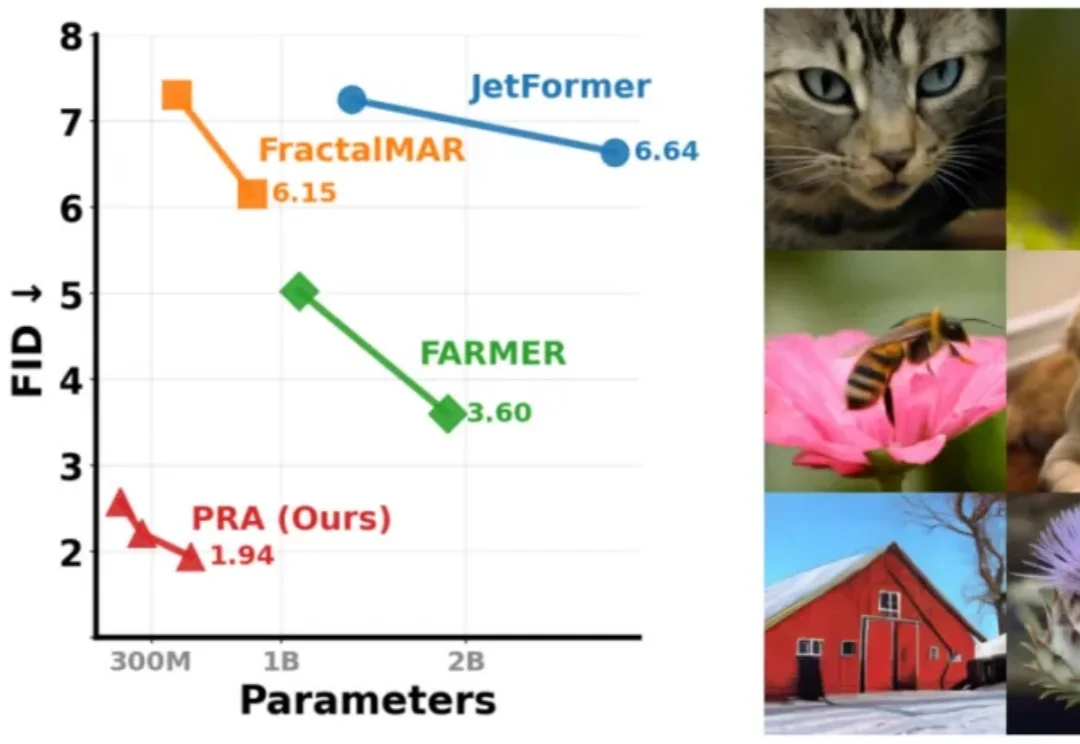
过去几年,扩散模型几乎定义了高质量图像生成:从随机噪声出发,经过多轮迭代,逐步 “雕刻” 出一张图像。但随着大语言模型席卷人工智能领域,另一条路线正迅速走到舞台中央 —— 图像,能否也像语言一样,通过自回归方式逐步生成?
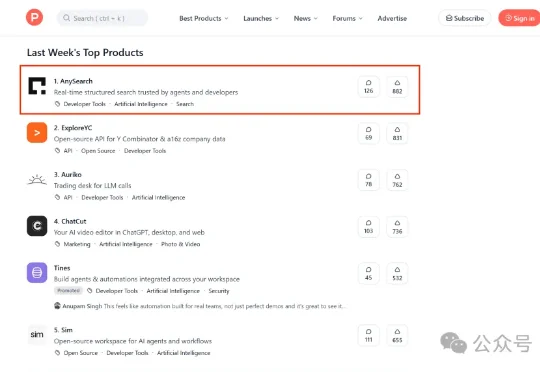
本期Product Hunt周榜Top 1出自中国团队,AnySearch——一款AI搜索产品。过去一年,PH榜一的位置被Agent、AI IDE、大模型轮番占据,几乎没见过搜索类产品的影子。就是因为在全球开发者眼里,普通AI搜索已经很难突围了。
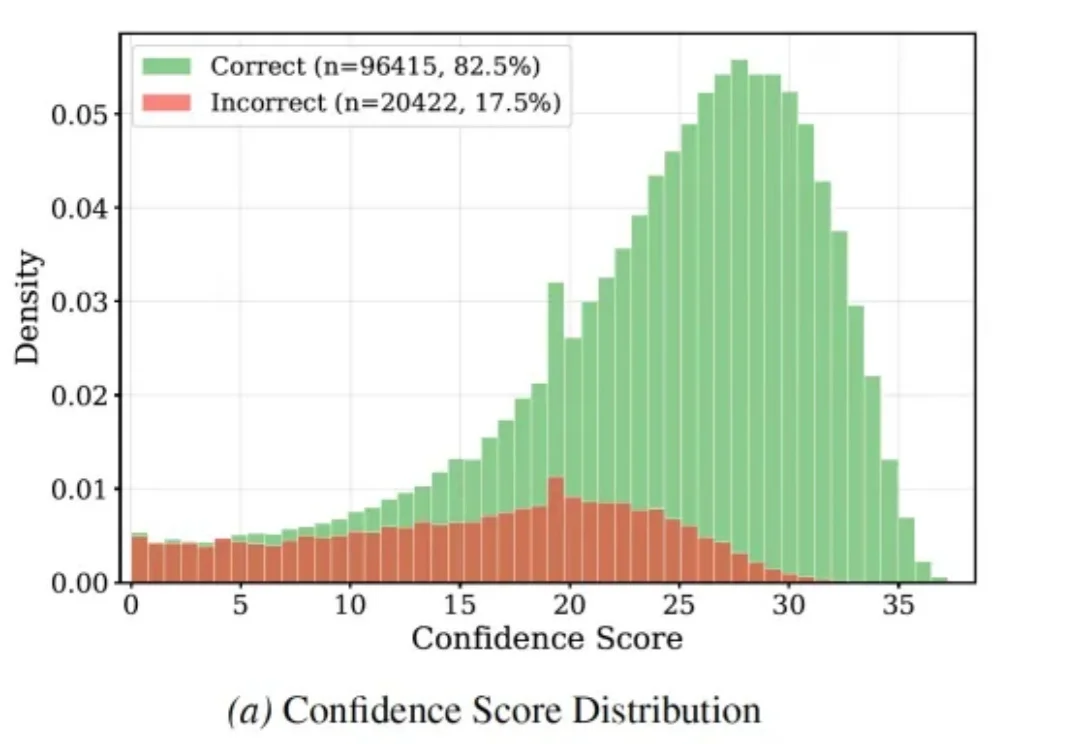
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
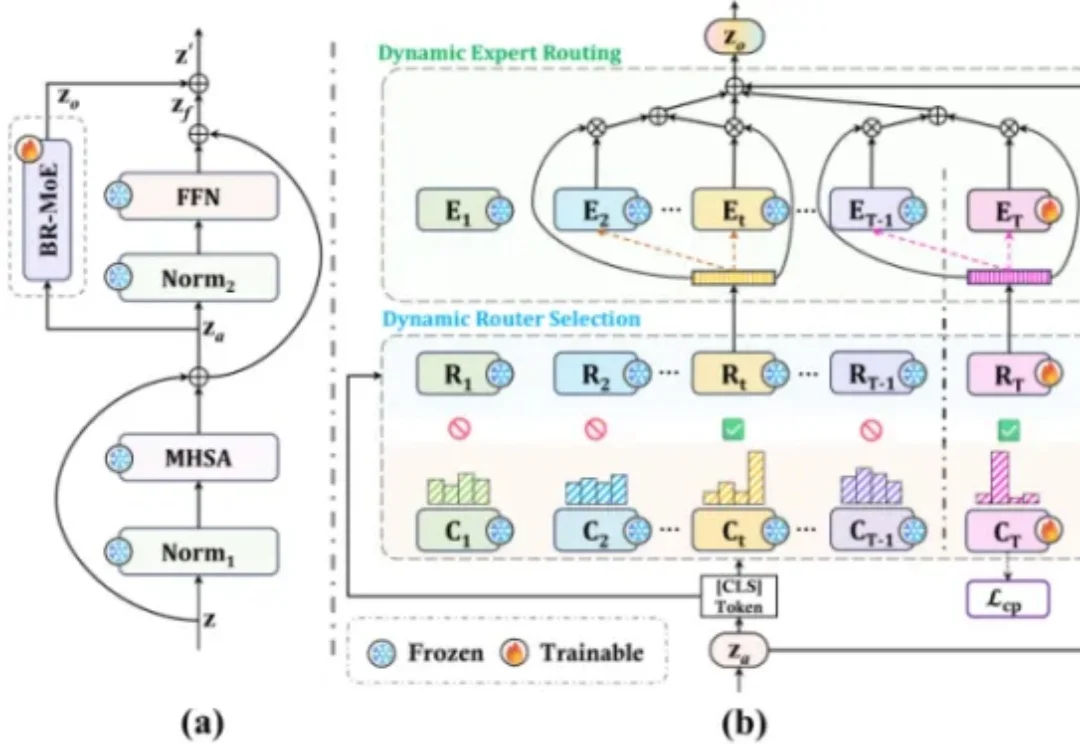
人类可以在一生中持续学习新知识,而不会轻易遗忘已有技能。然而对 AI 模型而言,这恰恰是一道极具挑战性的难题:每当模型学习新任务时,参数更新往往会覆盖历史知识,产生经典的 “灾难性遗忘” 难题。持续学习(Continual Learning)正是为突破这一瓶颈而生的研究方向。
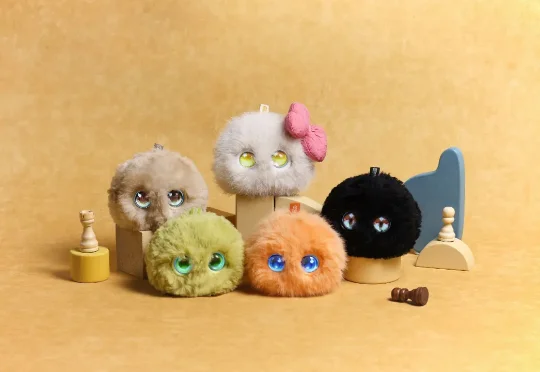
FounderPark 独家获悉,AI 潮玩品牌珞博智能(Robopoet)宣布于 2026 年初完成亿元级 Pre-A 轮融资。本轮融资新增华映资本、广和通、涂鸦智能三大新股东,同时老股东红杉中国、
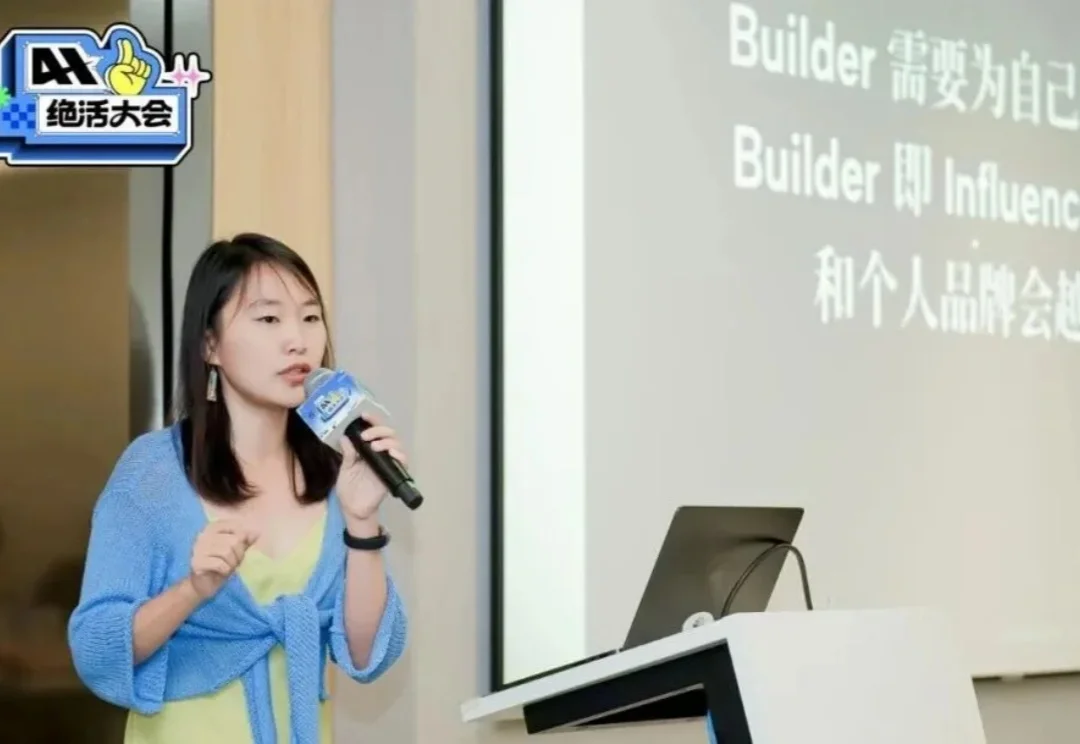
张咋啦 Zara 应该是中美 AI 圈子里几乎最出名的 Builder 了。
2026年,AI安全终于被推到了台前。
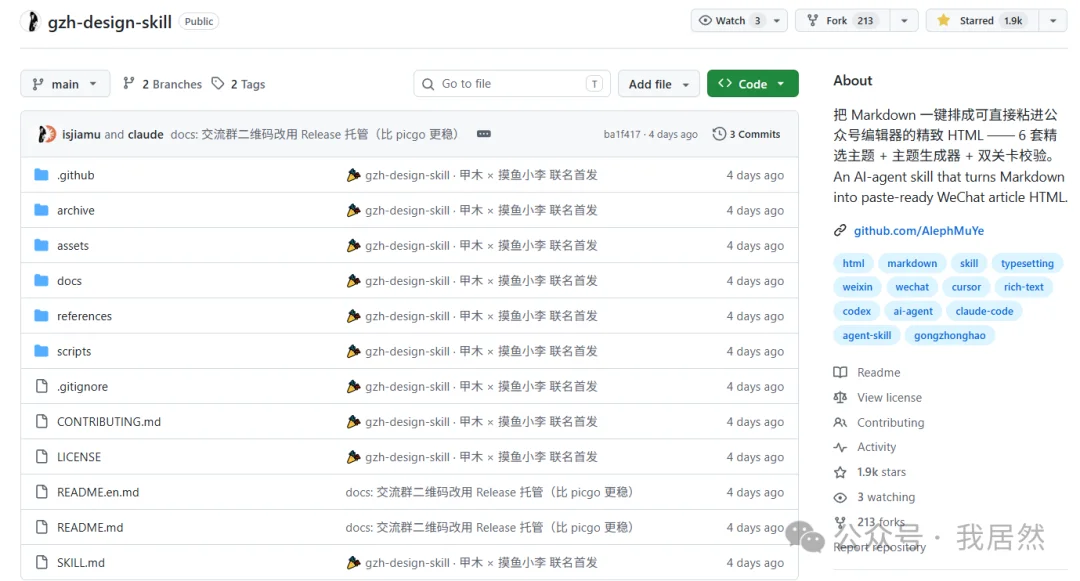
前几天在 github 上有个开源项目非常的火爆,就是 甲木 × 摸鱼小李 大佬联名首发的公众号排版 Skill ,不仅是设计有美感,而且又简约清新,不到几天,就斩获了 1.9k 的 stars
WorkBuddy最近很火,实测下来的体感是,harness层似乎搭建得还不错,而且对国内模型的兼容度都做得很好,少有的国内应用厂商做出来的、基于国产模型的可用Agent产品。 这篇文章来自 Work