
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
张牧涵博士,无涯智远(Norizon AI)创始人兼首席科学家,主要研究方向为持续学习、自进化智能体、图机器学习、大模型架构和推理等。曾任 Facebook AI(现 Meta AI)研究科学家,负责面向十亿用户规模的大规模图机器学习系统研发。现任北京大学人工智能研究院助理教授、研究员、博士生导师,首届国家级青年人才项目(海外)获得者。常年担任 NeurIPS、ICML、ICLR 等顶级学术会议领域主席。Google Scholar 总引用量超过 16000 次,2025 年起,连续两年入选 Elsevier 全球前 2% 顶尖科学家(终身影响力榜单)。
一个让人眼前一亮的结果
MIT CSAIL 的研究者发布了一篇博客《Sparks of Weight-Space Programming》。里面最抓眼球的是一组数字:GPT-6 Astra 不用梯度下降训练,只改动 Qwen3.5-0.8B 约 0.016% 的权重,就把 MATH-500 的成绩从 7.9% 提到了 48.1%。
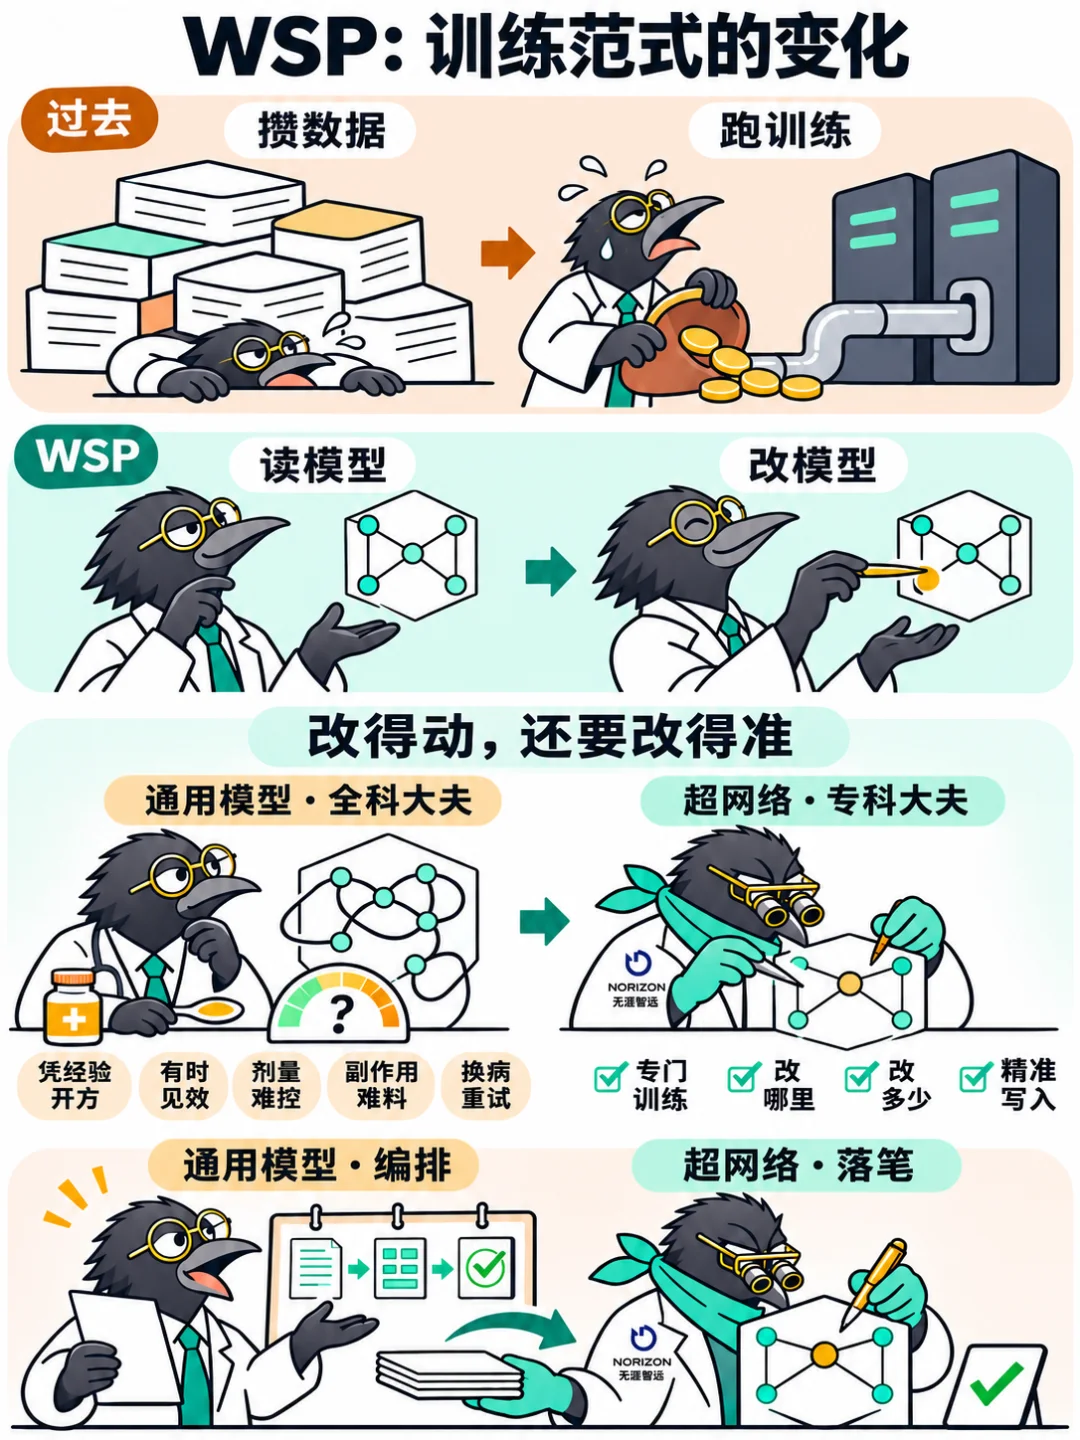
他们把这种做法称为 Weight-Space Programming(WSP):让一个足够强的通用大模型去读模型、分析模型,然后直接动手改写它的权重。
作为研究超网络和模型持续学习的学者,我对这个方向感到兴奋。
先说说我们自己。无涯智远是我创办的一家 AI 创业公司,只做一件事:让大模型出厂之后,还能像人一样边用边学。
今天常见的办法,是把上下文越拉越长,或者攒一批数据 "回炉重造" 一个新版本。我们选了另一条路:直接改模型参数,把新经历写进模型本身。
用的工具叫超网络。简单说,就是用一个网络去直接生成另一个网络的参数更新。给它一份新材料,一次计算就能完成写入,不必反复训练。它更像给模型装了一颗 "海马体":上下文是随手可清的短期记忆,写进参数的东西才会留下来,下一个任务还能用。
所以看到 WSP,我的第一反应是亲切:我们奔着同一个愿景 —— 不靠重新训练,让模型在使用中继续成长。手段却不一样:WSP 靠通用大模型现场推理、临时设计一次编辑;我们则事先训练好一个专门负责更新的模型。一个靠现场发挥,一个靠事先学会,两者很可能互补。
也正因如此,我更好奇一个问题:Astra 这样现场改权重,能不能帮模型真正吸收部署之后遇到的新知识、新规则和人类反馈,并在后面稳定地用起来?
围绕这个问题,我们做了一组补充实验。结果既给了我们继续探索的理由,也提醒我们:几种不同意义上的 "模型进化",得分开来看。
48.1% 旁边,该放一个什么基线?
先看原博客里一个容易被略过的细节:Qwen3.5-0.8B 的主要毛病,是开启思考模式后容易陷入重复循环,一遍遍绕圈直到耗尽 token。Astra 的干预减少了循环,让模型更有机会把话说完。作者自己也说得很清楚,修复循环和增加数学能力是两回事 —— 在很少出现循环的 Gemma 3 270M 上,MATH-500 只从 6.8% 变到 7.0%~7.7%,没有建立起有效提升。(原文实验)
于是我们补了一个很朴素的对照:不改权重,只是把思考模式关掉,会怎么样?
在同一套 MATH-500 测试集、相同的采样和评分设置下,未经任何编辑的 Qwen3.5-0.8B 关掉思考模式后,准确率是 48.95%。
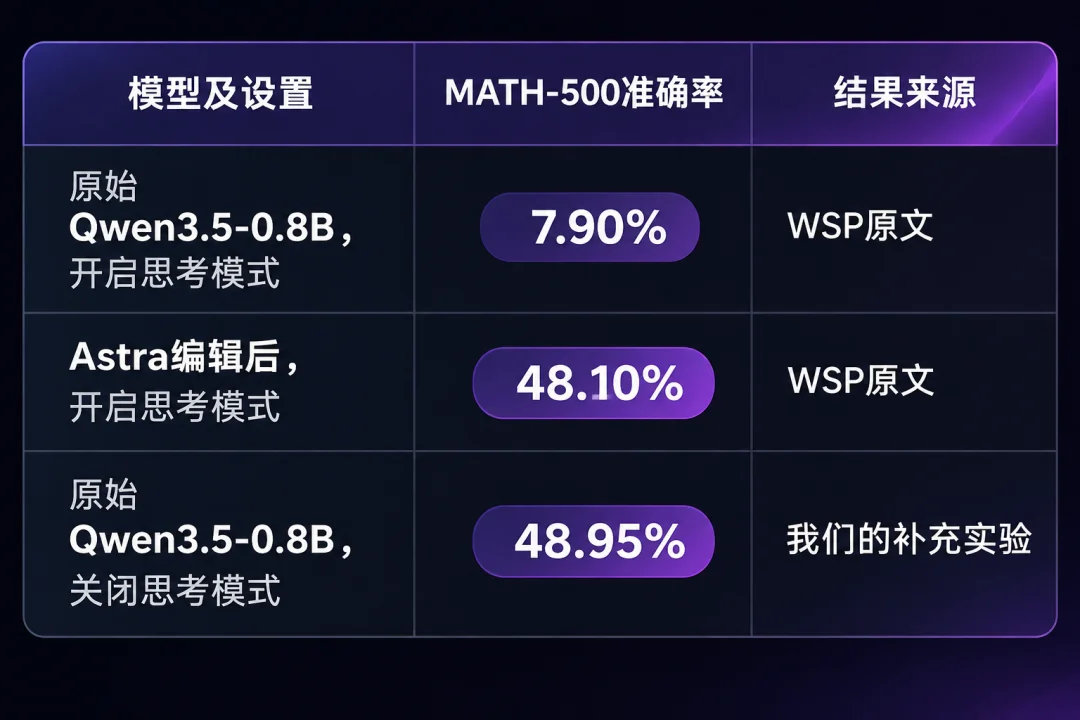
前两行来自原作者实验,第三行来自我们的独立测试。Qwen 官方模型卡本来就把 0.8B 设为默认非思考模式,也提示了它在思考模式下更容易出现循环。
这个对照改变了问题本身。对于一个绕圈到耗尽 token 上限的模型来说,权重编辑确实带来了明显改善;但和 "关掉思考" 这个几乎零成本的办法相比,它看上去没有额外收益。
我并不觉得这会抹掉 WSP 的价值。能够定位并干预一种内部行为机制,本身就是 Astra 推理能力的展示:它先发现失败大多来自重复思考,再对比正常推进与陷入循环的上下文,提取出内部表示里的 "重复方向",最后找到哪些神经元在往这个方向写信号,对两层 MLP 做了定向修改。这是一条完整、漂亮的因果链条。
更值得记下的是另一件事:权重不再只是一堆只能靠梯度下降慢慢挪动的数字,它可以被另一个模型像读文本一样读取、理解,再直接改写。过去想让模型变强,只有一条路:攒数据、跑训练;现在多了第二条:让模型去读另一个模型,然后写它。这不是又一种微调技巧,而是训练范式本身的变化。
真正的问题是,这条链条能延伸多远?面对一个陌生模型里更复杂、分布更广的知识和能力,Astra 还能不能找到对应机制,并事先判断一次修改的收益和副作用?WSP 给出了有价值的初步证据,但还不足以说明它已经建立起稳定、可迁移的 "参数 — 行为" 映射。
修改参数能否让模型学点新东西?
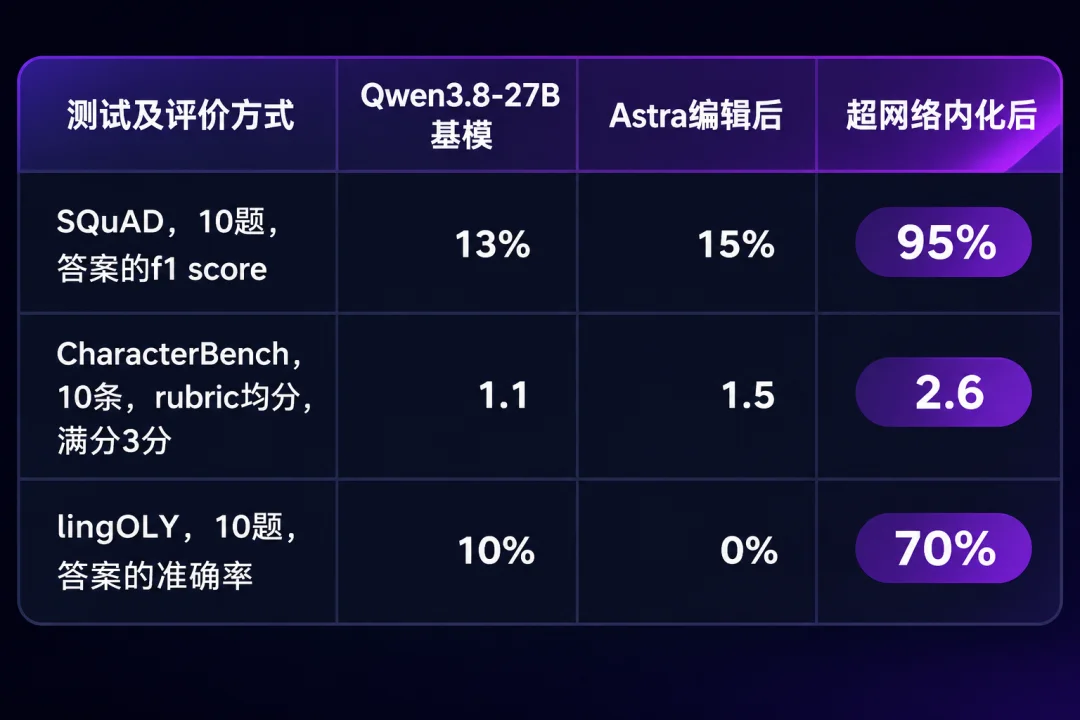
我们用 Qwen3.8-27B 作为共同起点,比较三种状态:未经更新的模型、 Astra 编辑权重后的模型,以及经过我们的超网络内化新知识的模型。
受 Astra 调用额度和执行速度限制,测试规模较小:从 SQuAD、CharacterBench 和 lingOLY 中各抽取 10 条样本,分别考察知识内化、角色与风格适配、技能内化。需要材料的环节,两种更新方法拿到的是同一份材料;回答时把材料撤掉,看看模型能否只靠更新后的参数作答。
知识:放大了信号,没换掉概念
在 SQuAD 上,超网络更新后的模型能在没有原始材料的情况下答出问题,另外两组都没有成功。
有个样本特别能说明问题。材料讲的是 Cestida(带状栉水母):靠身体波动和栉板列拍动游泳,已知只有两个物种。它和 Cestoda(绦虫)拼写很近,未编辑的模型恰好把两者搞混了。
Astra 的诊断并不含糊:它对比材料文本和绦虫描述在 MLP 层的激活差异,挑出对材料更敏感的那些神经元,把它们的输出分别放大 1.5 倍和 2 倍。权重确实改了,措辞也确实变了,但概念没变 —— 两个强度下,模型依然坚称 Cestid 是不会游泳的绦虫,依然说有四五千个物种。
放大一个和材料相关的信号,建立不了 "Cestida 指带状栉水母" 这条新关联。从相关性到因果,正是知识编辑最难跨过的一步。
风格:写进了参数,没写进人格
CharacterBench 上,经超网络更新后,模型的输出明显体现了角色和风格的要求,Astra 这一组则没有。
材料要求模型扮演 Evolto:一个傲慢、贪婪、爱用反问彰显优越感的反派。Astra 的做法,是计算 "有角色材料" 和 "无材料" 两种状态下某一层的激活差,把它作为一次修改写进单层权重。写入是成功的,权重张量确实变了,算术这类中性能力也没受影响。
可模型一开口就露了馅:自我介绍还是 "通义千问",被质疑本领普通时还是谦和地回应,被要求把最珍贵的东西免费分给大家,还是爽快答应。把同一个向量写进一层,没法在所有新问题、所有生成位置上都唤起同一个人格。相比之下,同一份材料经超网络内化后,回答里出现了傲慢、反问和角色特有的措辞。
技能:用得上规则,才算学会
lingOLY 考察的是技能:给模型一门陌生语言的简短学习材料,要求它学会其中的语法和词汇规则,再去做翻译和推理题。10 道题里,未经更新的模型答对 1 题,Astra 编辑后还是 1 题,超网络内化后答对 7 题。
Astra 的做法和前两例如出一辙:在第 43 层 MLP 上写入一次修改,可连它自己设定的检验题都没改过来 —— 材料要求把 "some change" 译成 grąžos,编辑前后模型都输出了 pinigų。只试了这一个候选之后,Astra 最终放弃修改,保留原权重。
学会一条规则,意味着能在没见过的题目、不同的句式、每一个生成位置上都正确运用它。一次局部的激活偏移,也许能让出题点附近的输出向材料靠拢,却保证不了这种覆盖。
三个案例,卡在同一个地方
知识、风格、技能,三类任务的失败指向同一个原因:Astra 编辑权重时,用的其实是一套经典的知识编辑工具 —— 比较激活、提取方向、缩放神经元、打一个秩一补丁。这套工具处理单点故障很趁手,比如抑制重复循环;但要把一份新材料变成可稳定调用的知识、人格或规则,精度和更新参数量就远远不够了。
它能找到与材料相关的激活,却找不到让最终行为按材料改变的因果方向;它能改动权重,却不能精确控制改完之后模型会说什么。工具本身还不够强,是这些失败最直接的原因。
这组实验足以提醒我们:大模型的知识内化、行为适配和技能习得,目前都不在 Astra 的现场编辑权重的能力范围内。
打个比方,让通用大模型现场给模型 "看病",像请一位什么病都看的全科大夫凭经验开方:有时确实药到病除,比如抑制重复循环;但剂量谈不上精确,副作用也难预判,换一种病症又得重新试一遍。
要稳定地把新知识、新风格、新规则写进参数,需要的是针对这件事专门训练过的手段 —— 知道该改哪里、改多少,也知道改完模型会怎么说。这更接近精准医疗,而超网络想承担的,正是专科大夫这个角色。
让 agent 来编排,让超网络来落笔
两者的互补,可以发生在同一个工作流里:由通用大模型做编排者,超网络做它手里那件负责写入的工具。
具体说,面对一份新材料,agent 可以决定哪些内容值得内化、怎么组织和切分这些文本、按什么顺序交给超网络;写入之后,再跑一轮评测,看新信息能不能被调用、原有能力有没有受损,然后据此调整材料组织或写入策略,重新试一次。内化文本的组织、调优和性能评测,都可以交给它来编排 —— 这恰恰是通用大模型擅长的事。
超网络只负责其中最需要精度的那一步:把文本精确对应到参数空间。我们的超网络是端到端训练出来的,在大量样本上学会 "什么样的文本,对应什么样的参数改动"。Astra 则是靠一次前向的激活差,临时凑出一个方向。前面三个案例里,缩放神经元、秩一补丁之所以改不准,缺的正是这样一件经过训练的写入工具。
二者结合,WSP 展示的现场推理能力一点也不会浪费,agent 越会编排,精确的写入工具就越有用武之地,这也正是我们期待 WSP 继续发展的原因。
回到开头那个数字:0.016% 的权重换来 48.1%,WSP 把 "读模型、做诊断、改权重" 串成了一条完整链路,这是很了不起的一步。
但改得动权重,不等于学会新能力。这几组实验里,参数确实变了,材料里的知识、角色和规则却没能变成可以稳定调用的东西。要让它们真正留下来,需要一个经过端到端训练、把文本精确对应到参数空间的写入工具。
所以我更愿意把 WSP 看作一块重要的拼图:通用大模型负责编排模型的更新,超网络让每一次更新在参数空间中落得准。两者接起来,模型出厂之后边用边学,才有一条能反复走的路。
权重能被改动的那一刻,只是起点。
文章来自于微信公众号 “机器之心”,作者 “机器之心”

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
