
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
AI视频,已经开始挑战「实时造世界」了!
9月初,Runway公布GWM Worlds 2研究预览,把音视频生成推进到了实时交互。
你让角色往前走,让房间涌进水,让沙尘暴卷过来,模型就接着生成后面的画面与声音。镜头怎么转、场景怎么变,都能继续下指令。

视频里的世界,开始跟着人的操作往下演。
但一个问题也跟着冒了出来:画面接得上,物理就一定说得通吗?
一篇名为PhysWeep的预印本,给「视频模型懂物理」泼了盆冷水。
研究人员测了三个开放视频生成模型。其中两个,在能追踪运动的样本里,暴露出一个问题:动作看着自然,物理参数却没按要求变化。生成结果,反倒更受随机种子左右。
画面演得挺像,物理题却做错了。
这道坎,恰恰卡在视频生成继续往前走的路上。
视频模型似乎学会了「马上回应」,却还没有学会「合理回应」:角色看似实时行动,场景随指令变化,但水为什么这样流、物体为什么这样倒、人物为什么此刻作出反应,仍在考验模型。
实时交互解决的是延迟,理解世界最需要的是逻辑。想让模型模拟事情如何发生,光靠几秒惊艳的画面,显然交不了卷。
就在这个节点,智象(HiDream.ai)发布原生全模态视频模型HiDream-O1-Video-1.0(下文简称HiDream V1)。
这是一款全新的「原生全模态」视频生成模型。它瞄准的,正是物理合理性、叙事规划和音画同步。
说得直白一点,就是让模型更懂创作者想要什么,生成的视频更连贯,也更接近可用素材。
首次参评,就在Artificial Analysis图生视频榜(含音频)杀入全球第四,Arena图生视频盲测榜全球第八。
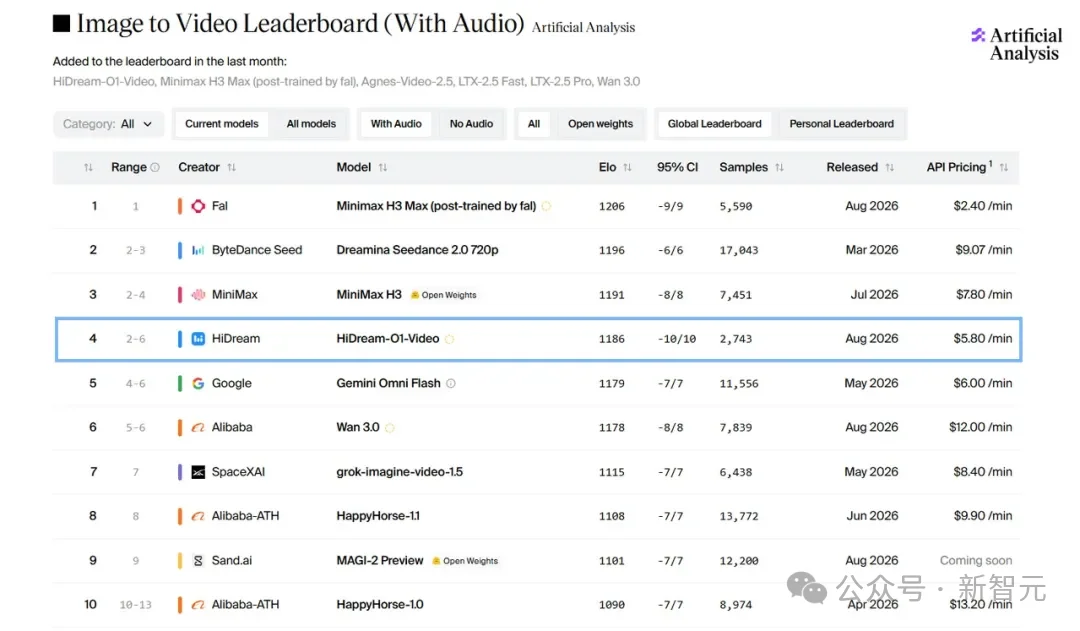
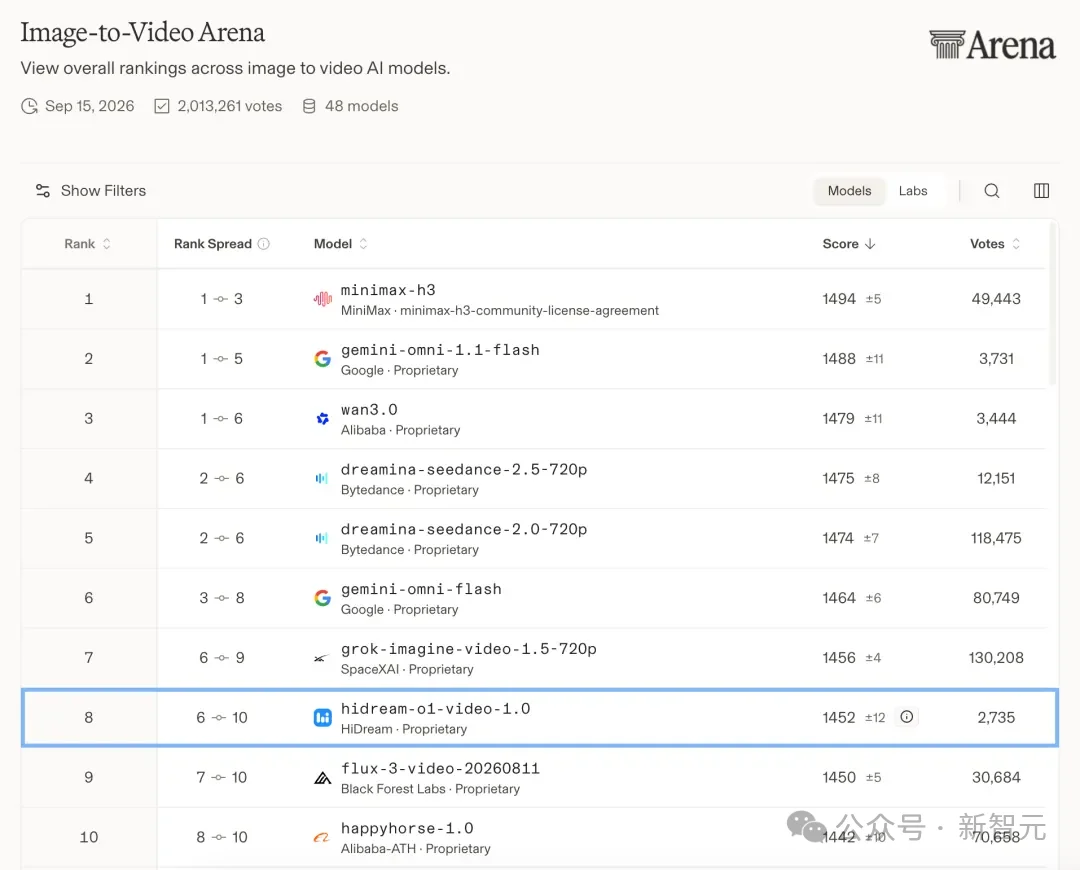
这一刻,在全球最顶级的多模态视频牌桌上,又挤上来一位狠角色——智象HiDream V1。
此前,MiniMax、字节Seedance、阿里万相,已经在全球AI视频赛道打出了声量。
如今,智象带着双榜前十的成绩,挤上了同一张牌桌。
中国AI视频「四小龙」,凑齐了。
1080P、5—20秒范围内灵活生成、音画一体化,这些是HiDream V1交出的基础配置。
更有意思的,智象给这套能力提出的要求:听懂人想拍什么,让动作按合理的顺序发生,让声音跟着画面里的事件走。
拯救「废片率」:当视频模型真的懂了物理规律
HiDream V1最令行业惊艳的能力,是对物理规律的理解与建模。
物体在重力下如何落下、碰撞如何反馈、惯性如何延续、光影如何衰减——这些物理规律直接被写进了视频模型的叙事之中,成为画面生成的底层逻辑。
对做视频的人来说,这件事只有一个衡量标准:素材可用率。
同一段镜头,过去反复抽卡才能挑出一条能用的,现在第一遍就能用——省下的每次重抽,都是实打实的时间和钱。
来看几组真实的同题对比测试。
场景一,高速赛车从镜头前疾驰而过,引擎声必须表现出逼真的多普勒效应。
A模型生成的画面中,赛车的车尾突然变成了车头。车还在往前跑,朝向却接不上了。
HiDream V1在这组演示中保持了行驶方向,引擎声也随赛车经过镜头,从高音调过渡到低音调。
这个场景要看的是,车的位置、朝向和声音变化,能不能对应同一次运动。车身再漂亮,中途突然掉个头,整段视频也会露馅。
多普勒效应听着专业,它管的是最朴素的一件事:引擎声卡在车经过的那一帧上,不用后期再逐帧对轨。


上:HiDream V1;下:A模型
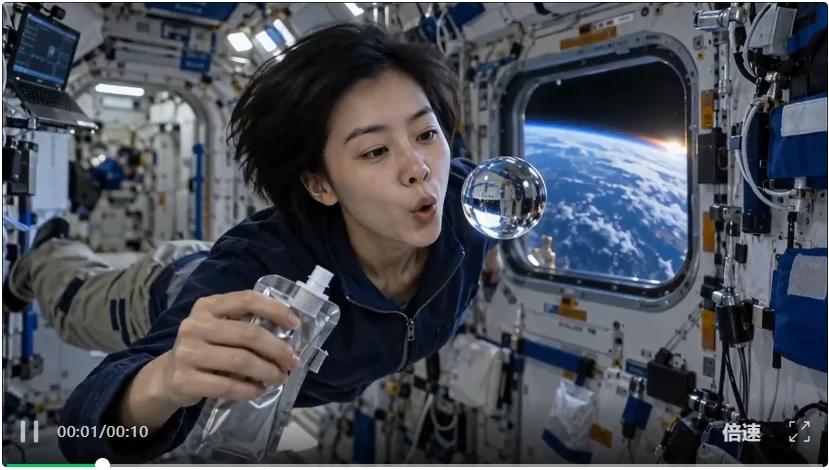
把场景搬到太空,连喝口水都成了一道物理题。
HiDream V1跑出来的画面,宇航员轻轻一吹,悬浮的水球随之晃动变形,再逐渐恢复圆润、缓缓飘远;她伸出手指拨回来,凑上前一口吸进嘴里。
这段最绝的地方在于,水球怎么变形、往哪边飘,每一步都严丝合缝地对上了人物动作,瞬间就把「太空喝水」那种失重的真实感给立住了。
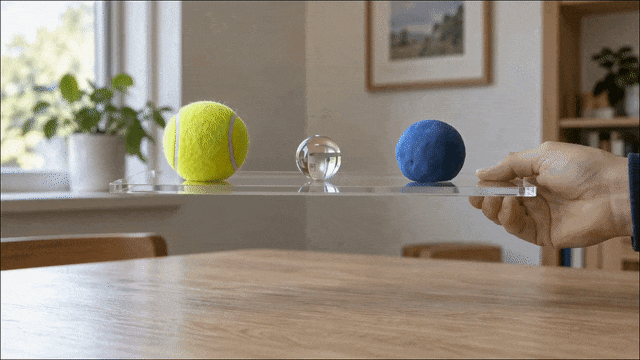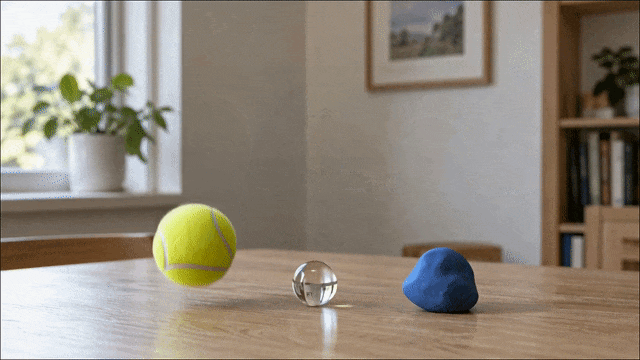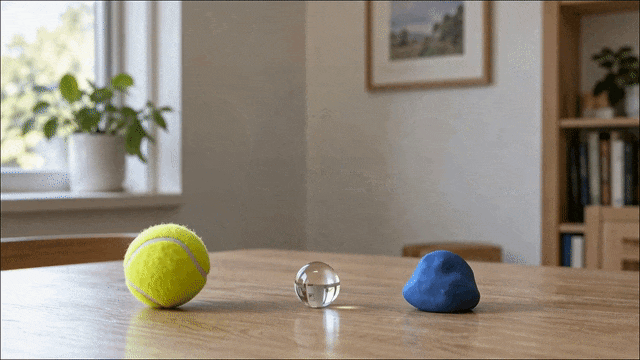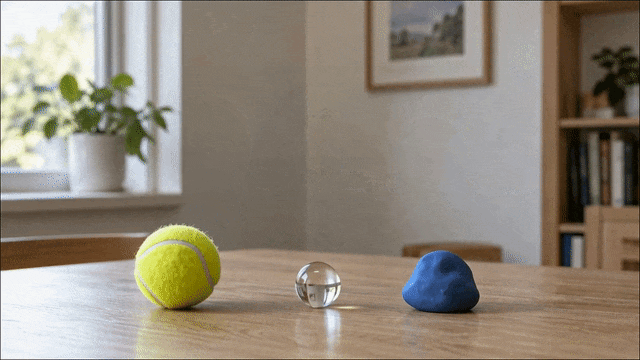
再把三种材质放进同一道题:抽走托板,让网球、玻璃弹珠和橡皮泥从同一高度落下。
HiDream V1生成的效果,网球落桌后明显弹起,玻璃弹珠的起伏小得多,蓝色橡皮泥则落地变形,留在原处。
同样是落到桌面上,三种材质交出了不同的反应,弹性和软硬的区别,也就有了直观的画面。
下面这个demo,看着简单,但考的其实也是最基础,也最容易翻车的物理规律——自由落体。
一大一小两颗铁球从同一高度同时松手,全程并排、同步加速,最后几乎在同一瞬间砸向地面。
HiDream V1把几个关键的细节,都接住了——
球没有一前一后乱飘,大小比例也没变,落地时还用一声重响、石板裂纹和扬尘把冲击感做了出来。
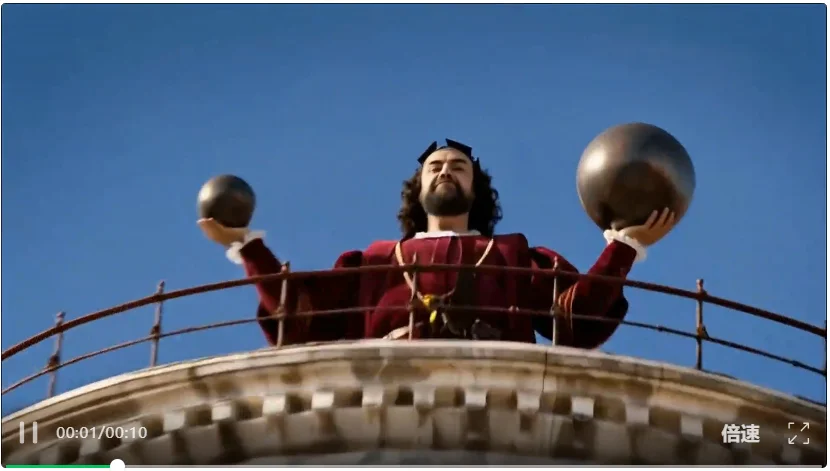
再来看农家小院里的压水井,男孩弯腰用力压下长杆,一股水随之涌进搪瓷盆,压杆抬起后,水流逐渐收细、停下。
HiDream V1把反复压水的过程接了起来,男孩身体的起伏、压杆的转动和水流的断续,有了对应的节奏。
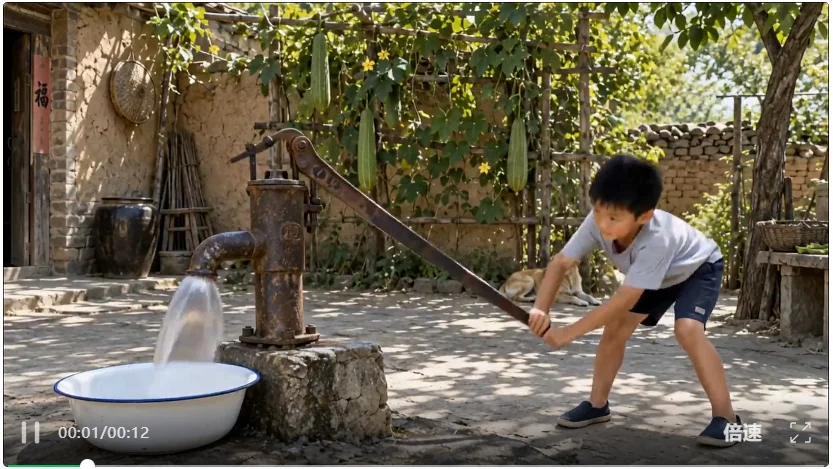
还有一个特别能说明问题的案例,一扇几百年历史的古堡老木门,双手极其缓慢地推。
A模型生成的画面中,物体扭曲变形,B模型则出现了用力方向和开门方向相反的荒诞画面。
而HiDream V1将缓慢推门的动作与门轴摩擦声对应了起来。
推门这个动作,藏着好几层约束:手的施力方向要与开门方向对得上,门要围绕门轴转动,摩擦声也得跟着动作走。
只要其中一环错位,再阴森的古堡、再逼真的木纹,都救不回这一幕。
顺便说一句创作自由度的变化:过去这种多层物理约束的镜头,基本没人敢写进提示词——写了也大概率翻车,宁可绕开。现在敢写,本身就是能力边界外扩的信号。


左:HiDream V1;中:A模型;右:B模型
这几组案例,把视频生成的难点摆到了眼前:单帧画面可以很漂亮,但一旦动起来,物体之间的关系就得连续成立。
视频里的下一步,得接得住上一步。
这一步之差,就是一秒视频和一条能用的镜头之间的差距。
AI听懂你在说什么了
当然,生成翻车,有时从第一步就开始了。
除了动作本身,模型还得先弄明白:用户到底想让什么事发生?
通常人们给到的提示,往往口语化、碎片化、模糊化。
比如,拍得紧张一点,就这么一句话,究竟是让人物表情紧张,还是镜头快速推进?
说「突然安静下来」,是关掉背景音乐,还是连环境声也要收住?
人和人沟通时,可以靠语境补齐。模型如果只抓关键词,就很容易把所有元素都画进去了,结果整段视频仍然不对味。
HiDream V1的做法完全不同。它在生成之前前置了多模态意图理解模块,先对视频内容进行结构化规划:
镜头时长、场景地点、画面内容、首帧约束、在场角色、动作表情、台词节奏、光色影调、景别构图、运镜焦段、背景声与音效设计……
可以把它理解成,把自然语言,转写为可执行的分镜语言。
理解越深,规划越稳;规划越稳,后续联合生成越不容易「跑偏」。
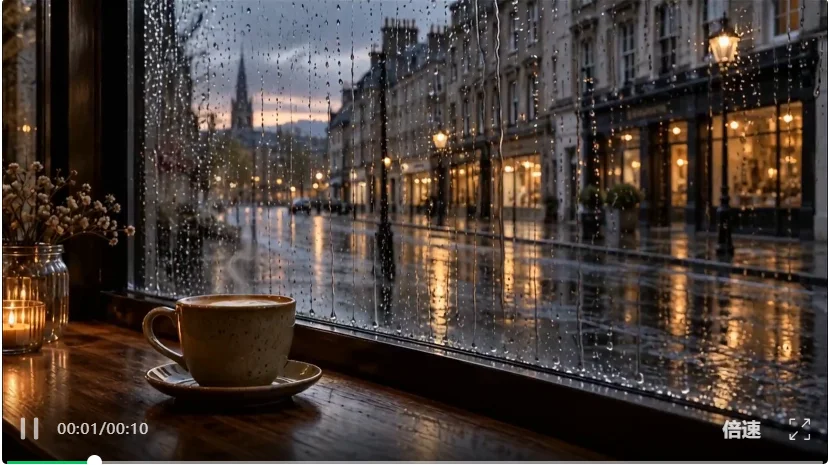
这次,我们连完整句子都没给,只丢过去几个词:「雨、咖啡馆窗、路过的红伞、慢一点、有点想家。」
HiDream V1生成效果如下,一把红伞从窗外缓缓走过,随后离开镜头,窗边的咖啡还冒着热气,整段留出了安静看雨的时间。
隔着雨窗看人来人往,那点「想家」的情绪,有了可以落脚的场景。
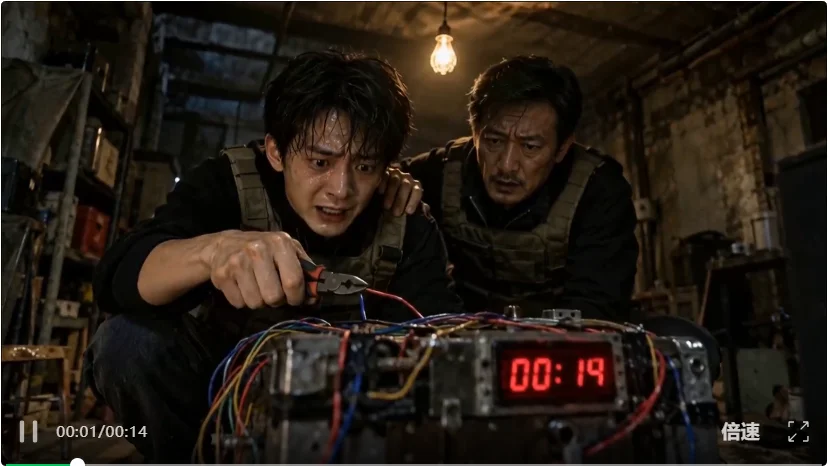
接下来,我们还设计了一个自带反转的「拆弹」戏——
两个人守着倒计时的盒子,为剪红线还是蓝线争得满脸紧张,钳子一合,喷出来的竟是生日彩带。
没想到,HiDream V1接住了这段剧情的转折,从剪线前的慌张到彩带扑脸后的错愕,把「先让人捏把汗,再让人笑出来」的意图演了出来。
时长自适应:不让秒表控制你的故事
另一个容易被忽视的变化,发生在时长上。
大多数视频生成模型遵循的是,固定提示词路线。
用户写「生成5秒」,模型就只能在这个时间窗口里填充内容,内容叙事被迫适应时长。
这听起来理所当然,但仔细想想,这是一个根本性的错位。
真实世界里,一件事该用多长时间讲完,是由事情本身决定的,不是由你手里的秒表决定的。
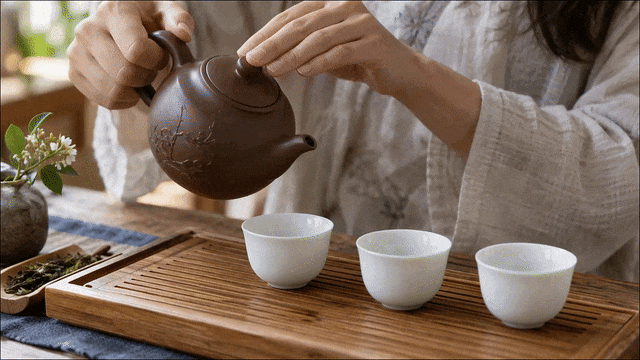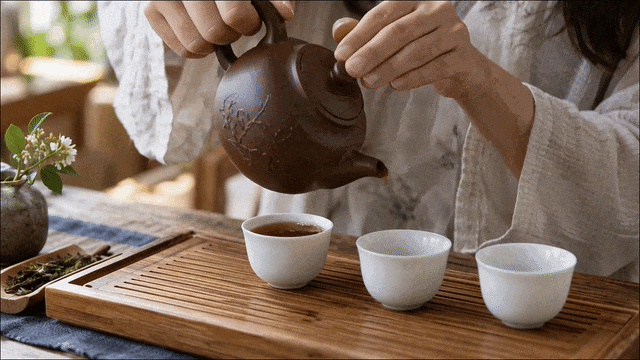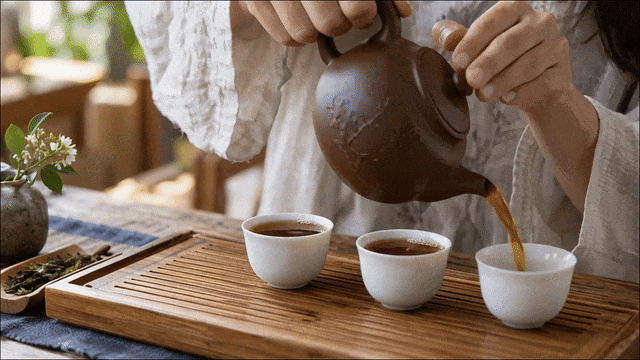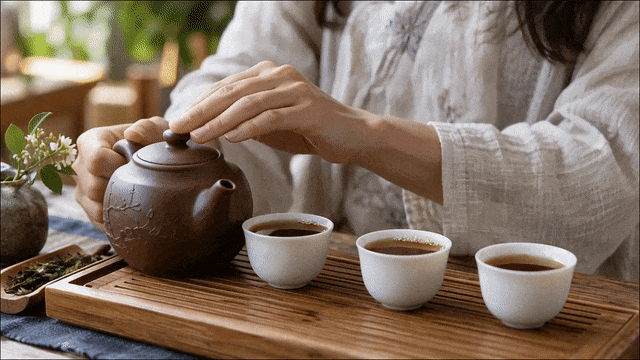
举个栗子,故意要求HiDream V1在3秒内,不紧不慢地把三杯茶依次倒满。
视频中,AI没有为了硬卡时长突然加速,而是让水流、水位和换杯动作自然接下去,把整件事完整做完。
该快的地方快,该停的地方停。时长服务的是叙事,而不是叙事迁就时长。
目前,HiDream V1原生支持5–20秒任意时长生成。
人们不需要再纠结「我该写几秒」——你只需要告诉模型你想表达什么,剩下的交给模型判断。该三秒就三秒,该十秒就十秒。
写提示词的体验也跟着变了,过去要在开头结尾反复写「注意重力、保持一致、不要穿模」这类补丁,现在这些是默认项,提示词只需要讲故事。
时长有了弹性,连续画面里的细节也得守住。
再看一个看似简单、却很考验细节的动作:原地转一整圈。
HiDream V1生成的视频中,女生转身露出背后的「07」,再转回正面,胸前的「NEW 2026」依然清晰,短发和黄色小包也保留了下来,最后还笑着歪了下头。
难点就在这一来一回:暂时离开视野的细节,重新出现时,还得接得上。

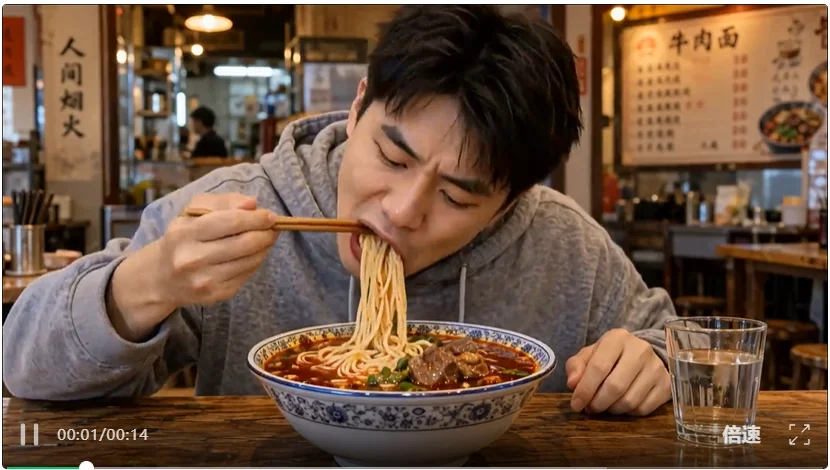
我们又让HiDream V1拍了一段嗦面,小伙把面条一根根吸进嘴里,接着拿起玻璃杯喝水,对镜头竖起大拇指,用四川话说出了「巴适」!
这段有意思的地方在于,嗦面占了大半段,喝水和最后的表情又各有停顿,一连串动作接下来,有了日常吃饭的节奏。
音画同步,是共生出来的
另外,音画不同步,是AI视频生成模型的一个「通病」。
原因在于,当前多数视频模型采用的是后期拼接路线:先逐帧生成画面,再回头配音配效。
就像先拍电影,再配字幕,总是差那么点意思。
HiDream V1则直接啃了块硬骨头,死磕「原生全模态架构」,对文本、视频、音频信号进行联合建模。
三者在同一生成过程中相互约束、相互对齐:画面运动牵引声音节奏,台词与音效反哺镜头情绪,文本条件贯穿始终。
毋庸置疑,效果也是立竿见影。
镜头切换时,环境声与配乐随之过渡;人物开口时,口型、气口与情绪同频;物理动作发生时,拟音效果与撞击反馈更贴近真实因果。
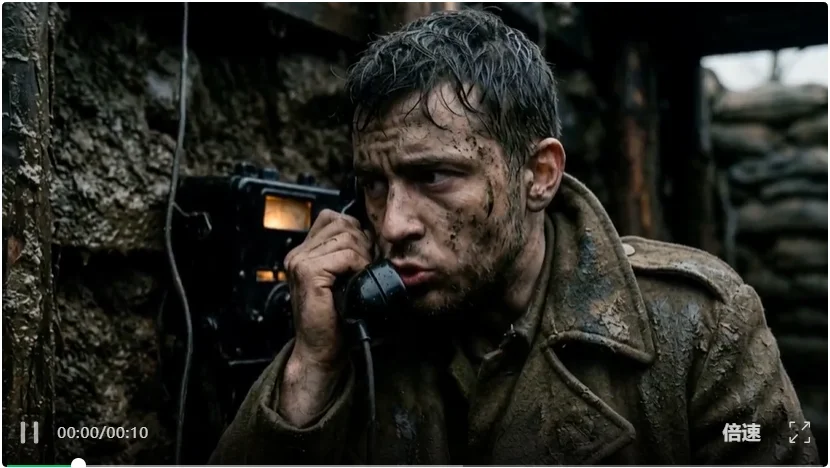
下面这个demo中,士兵从轻声耳语「我们需要支援」,突然切换为拼尽全力大喊「小心炮袭」。
D-V1不仅台词清晰准确,情绪的转换和音效的爆发力也与画面严丝合缝。
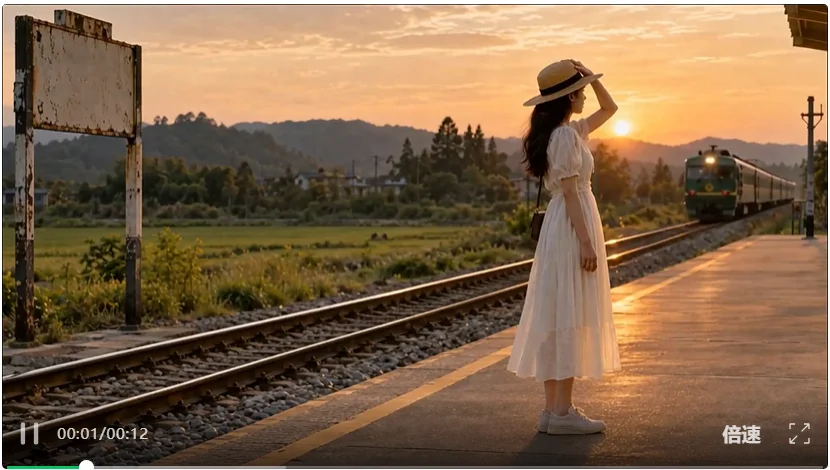
再听一列火车呼啸而过:汽笛由尖变沉,随列车远去,考验的正是声音能否跟上运动中的多普勒效应。
画面里,车厢依次掠过,女孩按住草帽,头发和裙摆被气流扬起,车过后才慢慢落回。
汽笛的变化、列车的位置和人物的反应,得落在同一次经过里,这一幕才有身临其境的感觉。
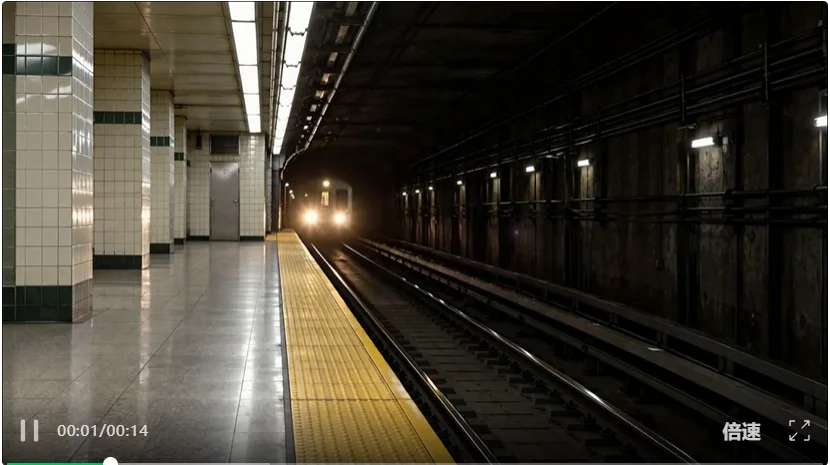
再来看个同款测试,列车从隧道深处一路驶来,由远及近音调升高、驶过后降低。
更细的一点是,车身高速经过时带起的风压,也准确传到了画面边缘被吹动的碎纸上,声音、速度和物体反应是对得上的。
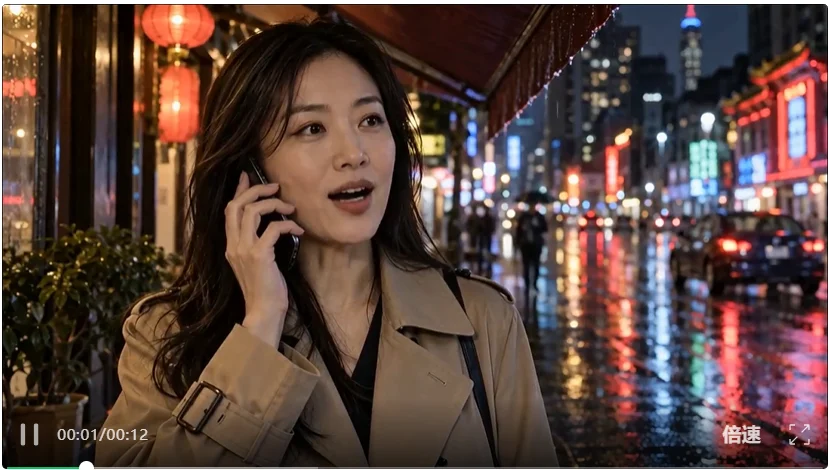
下面这个案例测的,是视频模型最容易暴露短板的地方:中文口型对齐和情绪切换。
前半段女主语气平静地说,「我马上到,你先点菜」,后半段听到消息后表情瞬间僵住,情绪起伏非常明显。
而且,每个字不仅念的准,还与口型一致。
现在,把意图理解、动作、画质和声音放在一起,新的问题来了:
这么多目标,怎么同时提高?
画面更锐利了,人物却变脸;动作幅度变大了,物体开始变形;声音很丰富,却抢掉了台词。视频质量很容易顾此失彼。
智象披露的技术路径是:先规划,再联合生成,随后通过多模态奖励信号进行对齐——后训练采用扩散模型强化学习(Diffusion RL),引入多模态Reward模型,对画面保真、叙事连贯、身份一致、物理合理性和音画同步等维度进行评估。
通俗地说,模型练习之后,还需要一套尽量接近人类观感的评分方式,帮助它往更好的结果靠近。
撑起这套后训练的,背后有三项顶会论文支撑——
DMSampler(ICML 2026)、DiffusionCompass(ECCV 2026)、EvoID(CVPR 2026)。
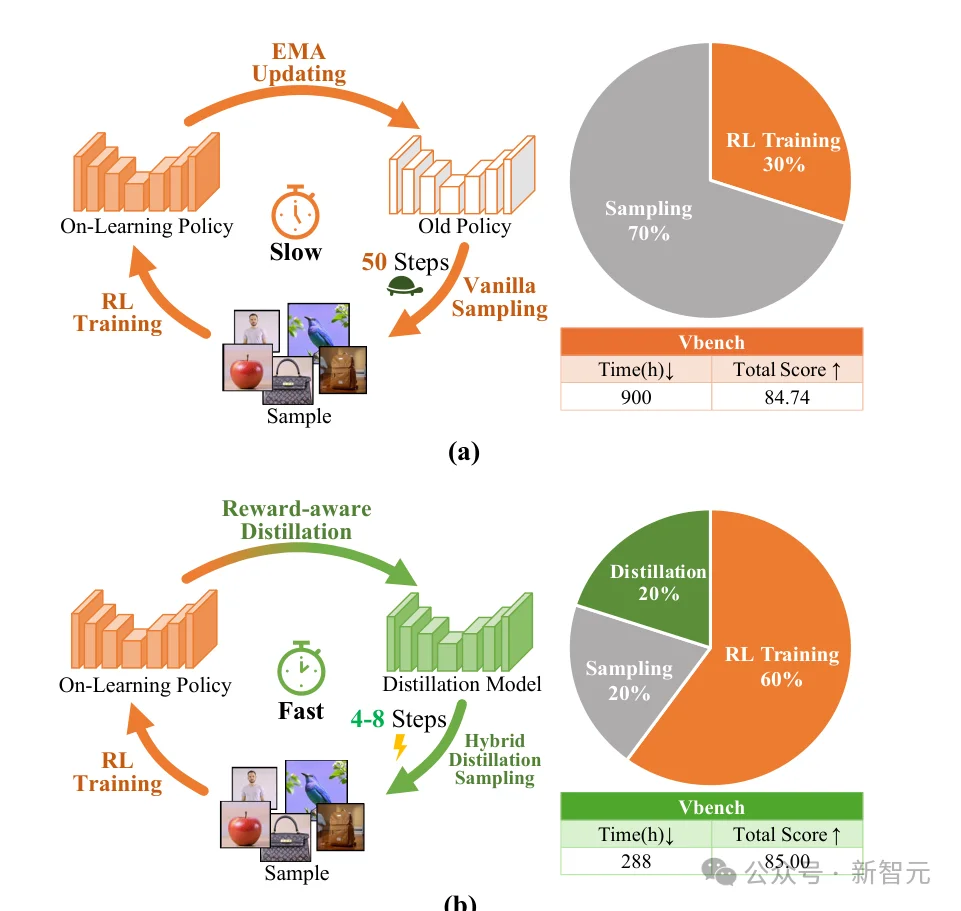
DMSampler:让模型练得起
视频模型每练一轮,都需要生成样本、获得反馈,再调整。生成本身就消耗计算,反复练习,成本很快叠上去。
DMSampler瞄准的,就是训练阶段的采样开销。
它用少步数的蒸馏采样器生成奖励评估所需的样本,并随着模型更新,周期性地重新蒸馏采样器。
这样,后训练就有机会以更低的采样成本持续推进。
这个改进首先服务于训练效率,不能直接换算成用户生成一条视频快了多少。但它解决了一个基础问题:模型想不断进步,得有成本可承受的练习方式。
DiffusionCompass:得分涨了,画面也得真的变好
练得起之后,还要防止练偏。
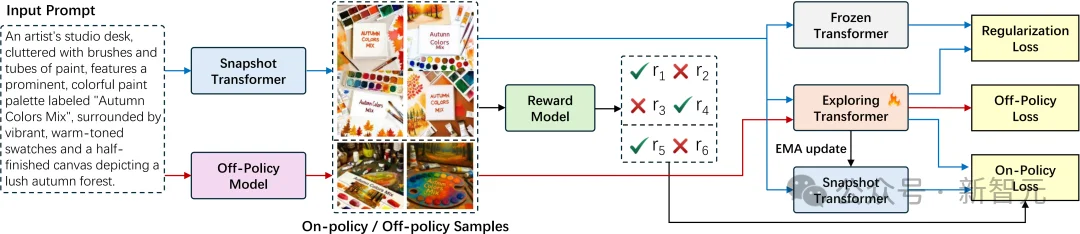
强化学习依赖奖励反馈。如果模型过度迎合评分方式,可能出现分数提高、生成多样性下降,甚至钻评分规则空子的情况。
DiffusionCompass给训练引入了外部高质量样本作为参照。
DiffusionCompass架构
模型继续用自身生成的样本探索,同时借助这些质量参照校准优化方向,减少奖励过拟合和「刷分」的风险。
这就是「质量锚定」,模型追求更高奖励时,要有可靠的生成质量作为参考。
放到创作者的需求里,这件事很好理解。谁都不希望模型只学会讨评分系统喜欢,却把画面越练越单调,或者丢掉原本自然的细节。
EvoID:动作再大,也得认得出是同一个人
第三项研究,落在视频最容易让人出戏的问题上:身份保持。
一个角色正面看是一张脸,转个头却像换了演员。对于要拍连续剧情的人来说,这样的素材再漂亮,也很难接着用。
EvoID对应的正是身份保持这一环,为生成过程中维持人物身份一致提供研究支撑。
这里要守住的,是角色在动作、视角等变化中的可辨认性。人物可以转身,可以改变表情,观众仍应认得出:这是刚才那个人。
低成本采样、质量锚定、身份保持,三篇论文串成一条线:一篇负责省,一篇负责准,一篇负责稳。而省、准、稳,最终都会落到创作者的同一本账上。
视频生成的单价在下降,但动作变形、人物变脸和结果偏离预期,依然可能让创作者反复尝试、重新等待。
前面的采样效率、物理合理性评估、质量锚定和身份保持,解决的正是这些藏在单价之外的成本:
让模型生成得更稳一些,让素材离「可用」更近一些,也让每次尝试少一点无效消耗。
但如果只把HiDream V1当成「又一个视频模型」,就低估了它在智象棋盘上的位置。
要看懂这一步,得先看智象整盘棋的下法:一个底座,四类模型。
底座只有一个,叫UiT——智象自研的统一架构,今年4月以「原生全模态世界模型HiDream-O1」的名字发布。
从那之后,四类模型全从这一个底座上长出来:
图像模型HiDream-O1-Image,主打「空间理解」。商用版1.5版本在Artificial Analysis文生图榜单中取得中国第一、全球第二。
交互式世界模型HiDream-O1-World,名列行业首个交互式世界模型基准WBench综合总榜第一。该模型具备漫游、编辑、交互三大功能,时空一致性和物理一致性实现关键突破。
具身世界模型HiDream-O1-Embodied,在RoboColiseum的扰动适应和空间推理子榜单中登顶榜首。
随着HiDream V1的发布,业内首个原生全模态世界模型闭环就此成型。
图像、视频、3D交互与具身动作,在统一原生的世界模型中交汇、共生、循环。
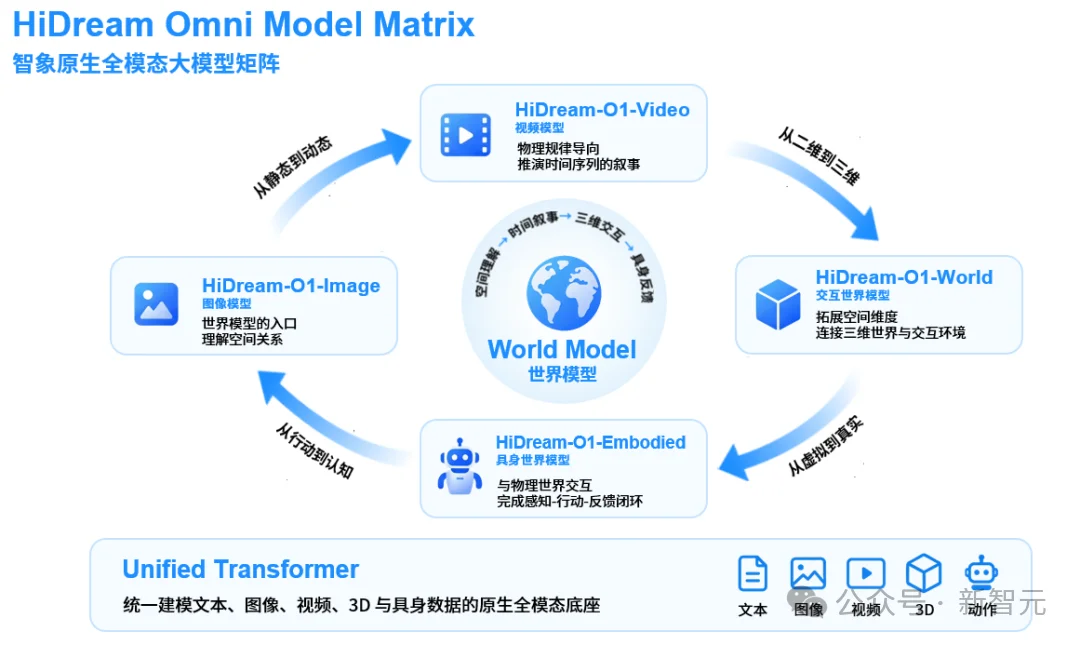
图像负责呈现空间,视频加入时间变化,交互和具身模型进一步涉及动作与反馈。
用创始人兼CEO梅涛一句话概括,智象要构建的是「一个原生全模态底座、四大模型同源演进」的矩阵。
这四条线不是各自为战,而是一套面向世界模型持续进化、走向落地的体系。
从模拟世界,到理解世界
AI视频模型的下一个突破点在哪里?
分辨率更高、画质更细、时长更自由,当然都重要。
但当一段视频真正动起来,观众还会追问:这件事,现实里会这样发生吗?
手推门,门得顺着合理的方向开;苹果抛出去,要沿着连贯的轨迹被接住;骨牌倒下,碰撞得一块接一块传过去。
这些细节单独看都很小,连起来,却决定了整段视频能不能让人信服。
HiDream V1这次值得关注的,也正是这条方向:把物理合理性与意图理解、叙事规划、音画生成放到一起,让模型在追求画质之外,继续处理运动、交互和前后状态。
几组demo还不足以证明模型已经全面掌握物理规律,但它们把接下来该比什么,摆得更清楚了。
从「看起来像真的」,走向「事情真的会这样发生」,才是视频模型继续抬高能力上限的关键。
这也接上了智象布局世界模型的思路:感知当前状态,推演变化过程,再进一步回答行动会带来什么结果。
一个UiT底座、四类模型同源演进,视频补上的这一环,最终要经得起连续事件的检验。
画面可以惊艳一秒,真实得经得起下一秒。
文章来自于"新智元",作者 "桃子 摩西"。


【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
