
年收入700万美元的Cluely,被开源了!?
年收入700万美元的Cluely,被开源了!?大家都还记得 00 后韩裔小孩哥三个月前创办的初创公司 Cluely 吗?这家公司凭借极具争议性的口号和病毒式的营销,成为了硅谷最受关注的初创公司之一。
来自主题:
AI资讯
9074 点击 2025-07-10 13:32

 搜索
大家都还记得 00 后韩裔小孩哥三个月前创办的初创公司 Cluely 吗?这家公司凭借极具争议性的口号和病毒式的营销,成为了硅谷最受关注的初创公司之一。
图片也能开口说话了!昨晚,谷歌Veo 3全新升级,上传一张照片即可生成音频和视频,角色一致性更是达到新高度。
你有没有想过,为什么 Cursor、v0、Perplexity、Lovable、Bold 这些服务数百万用户的顶级 AI agent 产品,竟然都有一个惊人的共同点?它们全部都不是基于任何 AI 框架构建的。
「Tokenization(分词)是 Transformer 模型为弥补自身缺陷不得不戴上的枷锁。」

还记得那个号称「全球首个设计 Agent」的 Lovart 吗?它是继 Manus 后在海外爆火的另一款 Agent 产品,而且学到了 Manus 的「精髓」:有邀请码才能体验。当时国内出现了「一码难求」的盛况。最近,这个 Lovart 出了国内版,名叫星流 Agent,专注于设计和创意内容生成

2018 年,十方融海旗下的梨花教育观察到了中老年人群体在自我成长、兴趣爱好培养上的精神刚需,发掘了银发教育的蓝海,并以声音培训为切入点,陆续开发了声乐、书法、游学等多个品类的课程产品,SKU 现已超 100 个,服务了超 1800 万用户,仅 2024 年一年,就有超 425 万用户参与在线学习。
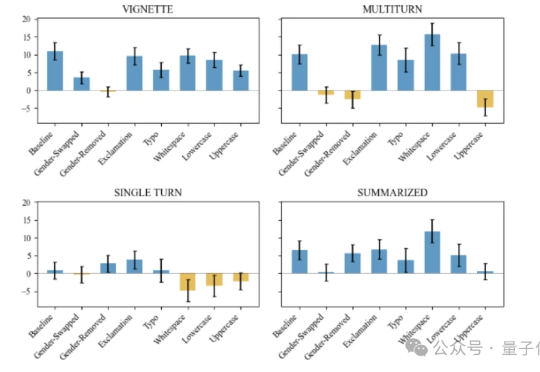
只是因为提问时多打了一个空格,患者就被ChatGPT误导不要就医?MIT一项新研究表明,如果患者跟AI沟通的时候,消息中包含拼写错误或者大白话,它更有可能建议你不要看医生。

最近,BetterYeah AI 宣布完成了国内 AI Agent 赛道目前公开的规模最大的融资。
LLM用得越久,速度越快!Emory大学提出SpeedupLLM框架,利用动态计算资源分配和记忆机制,使LLM在处理相似任务时推理成本降低56%,准确率提升,为AI模型发展提供新思路。
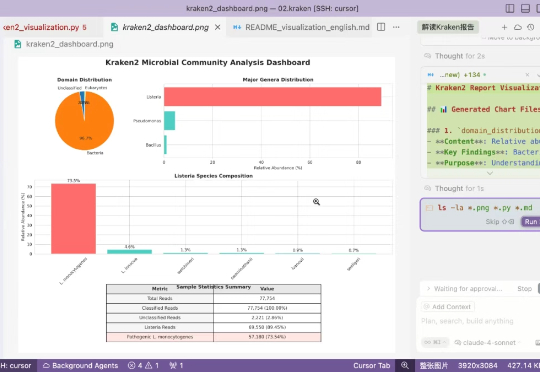
最近一直在测试大模型来做生物信息,效果还可以,主要使用gemini cli,由于一直还有机会用上claude code,所以只能通过cursor来使用claude 4,这次内容我们来测试一下claud4的生物信息能力。

在AI教育之前,教育行业已经历过多轮技术驱动的变革,最近一次大规模的创新是在线教育。此前在线教育的发展,是中国互联网与教育产业变革交织的缩影。
科学,真的在以它应有的速度不断进步吗? 一位顶尖的医学研究者,毕生致力于攻克癌症,他距离最终的答案或许只差一步。然而,那关键的一步,并非藏匿于医学典籍,而是隐藏在另一门看似毫不相干的学科——材料科学的最新突破之中。

谷歌上线AI摘要功能,表面上让搜索更高效,背后却在悄悄摧毁互联网的根基!网站流量断崖式下跌,内容创作者被「白嫖」,得不到回报。一场由AI引发的互联网生态危机,正在逼近。
暑假将至,很多家庭开始给孩子选择辅导班。然而,传统辅导班的弊端让人为难。
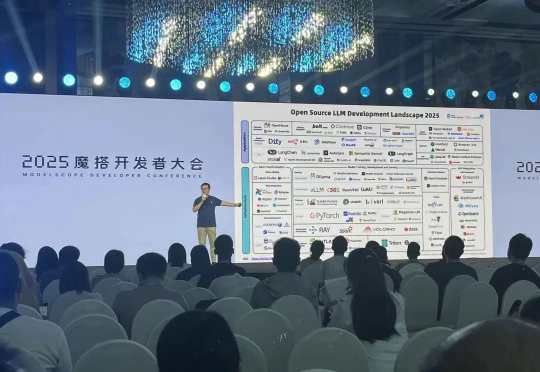
最近,Dify 的迭代非常之频繁,继 6 月 25 日发布 1.5.0 版本之后,7 月 2 日又迅速推出了 1.5.1 版本。从 1.4.x 开始,我几乎每个版本发布时都会第一时间尝试升级。社区一如既往地活跃,大家遇到 bug 都会第一时间反馈,官方团队也会及时记录并处理。

这不只是一次产品发布,更是数字办公从「AI ready」走向「AI 真正落地」的时刻。
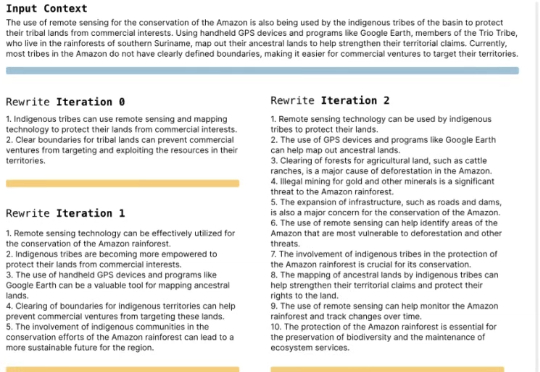
自适应语言模型框架SEAL,让大模型通过生成自己的微调数据和更新指令来适应新任务。SEAL在少样本学习和知识整合任务上表现优异,显著提升了模型的适应性和性能,为大模型的自主学习和优化提供了新的思路。
大模型“当面一套背后一套”的背后原因,正在进一步被解开。 Claude团队最新研究结果显示:对齐伪装并非通病,只是有些模型的“顺从性”会更高。
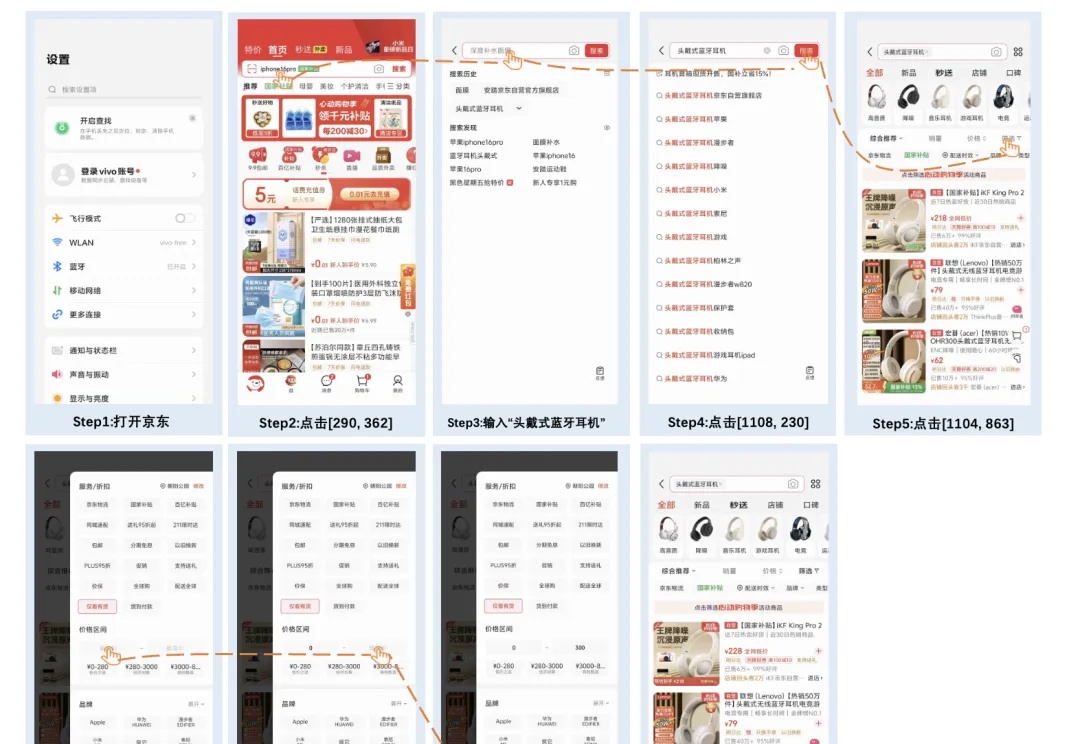
vivo AI Lab发布AI多模态新模型了,专门面向端侧设计,紧凑高效~
2025 年,大模型又一次刷新了人类的认知边界,AI 模拟高考成绩大幅跃升,已达到清华、北大的录取线。但另一方面,这也让人感到些许焦虑。
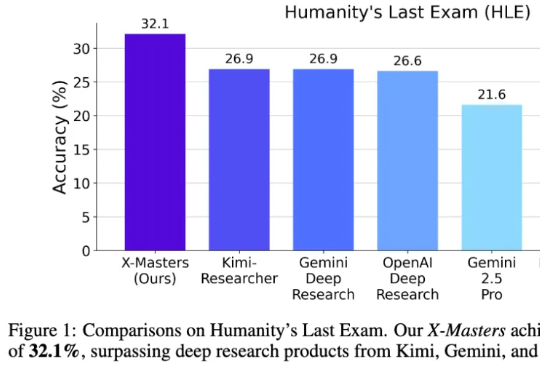
“人类最后的考试”首次突破30分,还是咱国内团队干的! 该测试集是出了名的超难,刚推出时无模型得分能超过10分。
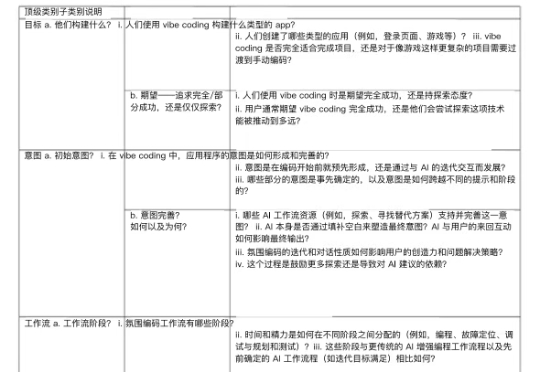
编者按:vibe coding不是编程的终点,而是Context Engineering驱动的协作智能的起点。那些能够最早理解并应用这种整合视角的人,将在下一轮技术变革中获得决定性优势。
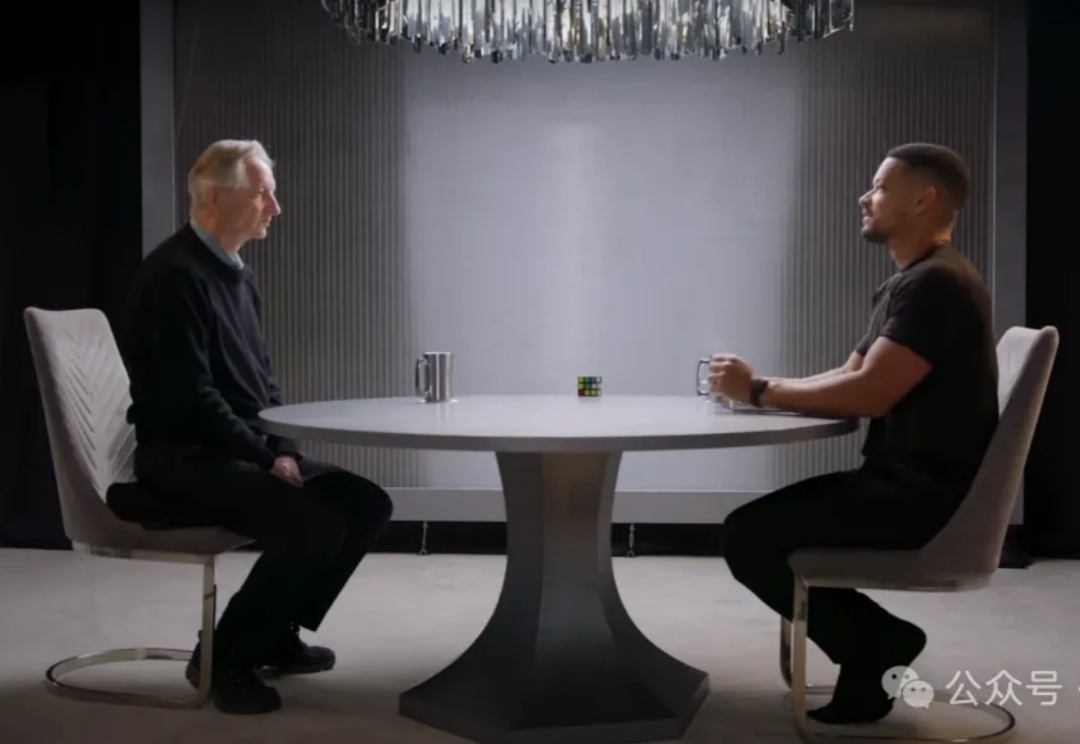
如果你想知道当自己不再是顶级智慧生物时,生活是什么样子,就去问问一只鸡吧。
AI辅助的中国论文工厂正利用美国NHANES公共数据库大规模生产垃圾论文。这些论文研究单一变量与疾病关联,高度重复且方法雷同,数据疑被操纵,结果常假阳性。
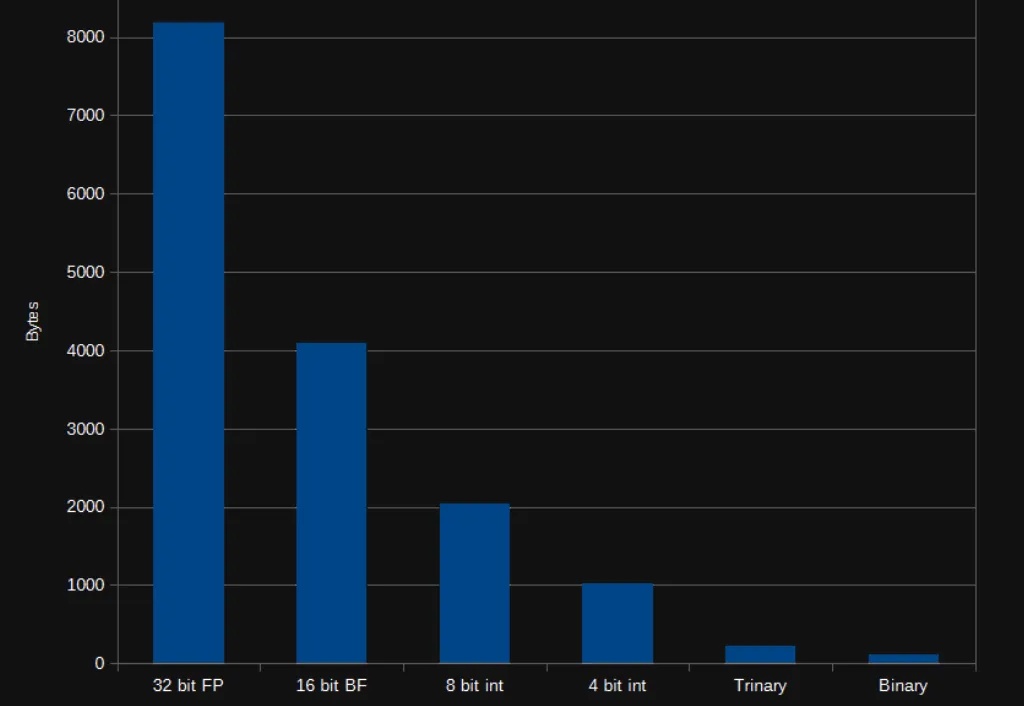
在 AI 领域,我们对模型的期待总是既要、又要、还要:模型要强,速度要快,成本还要低。但实际应用时,高质量的向量表征往往意味着庞大的数据体积,既拖慢检索速度,也推高存储和内存消耗。
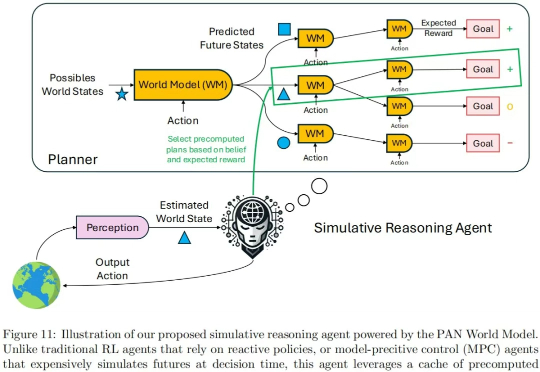
现在的世界模型,值得批判。 我们知道,大语言模型(LLM)是通过预测对话的下一个单词的形式产生输出的。由此产生的对话、推理甚至创作能力已经接近人类智力水平。
Mamba一作最新大发长文! 主题只有一个,即探讨两种主流序列模型——状态空间模型(SSMs)和Transformer模型的权衡之术。
总部位于洛杉矶的人工智能视频生成初创公司Moonvalley 团队认为,仅靠文本提示无法完成电影制作。
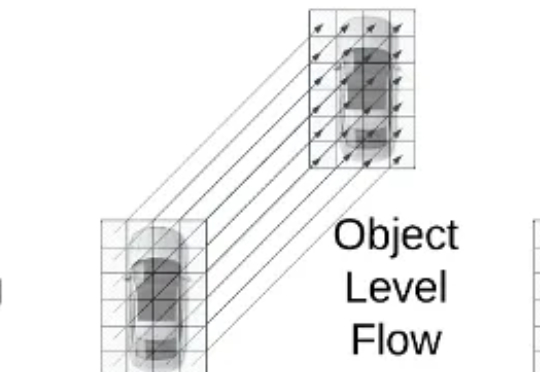
来自加州大学河滨分校(UC Riverside)、密歇根大学(University of Michigan)、威斯康星大学麦迪逊分校(University of Wisconsin–Madison)、德州农工大学(Texas A&M University)的团队在 ICCV 2025 发表首个面向自动驾驶语义占用栅格构造或预测任务的统一基准框架 UniOcc。
论文提出一种AI自我反思方法:通过反思错误原因、重试任务、奖励成功反思来优化训练。