刚刚,源策未来发布 Anchor 1:让人形机器人真正做到精准控制
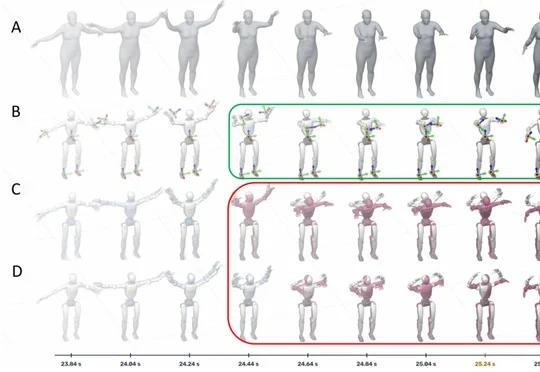
刚刚,源策未来发布 Anchor 1:让人形机器人真正做到精准控制源策未来(Archon Robotics)发布全身控制模型 Anchor 1,通过五个锚点、筛选训练数据与解耦误差反馈提升人形机器人全身操作精度和稳定性,并计划于 2026 年底分阶段开放模型权重及部署代码。
来自主题:
AI资讯
8696 点击 2026-11-06 15:53

 搜索
源策未来(Archon Robotics)发布全身控制模型 Anchor 1,通过五个锚点、筛选训练数据与解耦误差反馈提升人形机器人全身操作精度和稳定性,并计划于 2026 年底分阶段开放模型权重及部署代码。
AI 推理基础设施公司 Fal 同时披露 Series E 和 Series F 两轮融资合计 16.5 亿美元,估值半年由 80 亿美元翻倍至 160 亿美元;其以统一 API 接入数百个图像、视频和音频模型,年化收入从约 2 亿美元增至 8 亿美元以上,并获 Nvidia 等投资。
墨芯人工智能完成近10亿元人民币C+轮融资,距上一轮近10亿元融资仅5个月,并正依托专用稀疏推理芯片技术加速规模化落地与商业化。
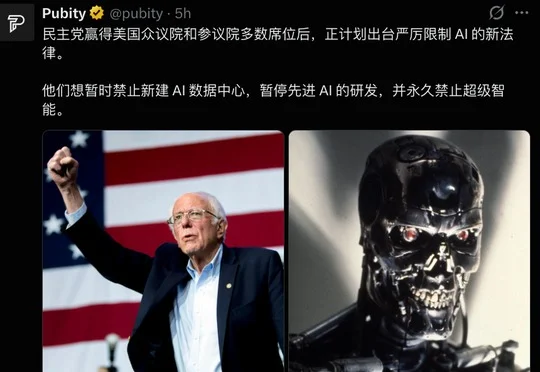
Sam Altman将X显示名称改为Ram Altman后,美国拟严限AI发展的消息引发美股一夜蒸发2.8万亿美元,OpenAI据报正讨论将2027年数据中心容量预期下调40%。
Google 宣布自2027年初让美国K-12学区自主决定是否启用Gemini等AI功能,却将关闭AI与失去Google Search捆绑,引发其借搜索优势强推AI的争议。
自然选择已完成累计超1亿美元的A+轮融资,新投资方包括五源资本、启明创投、源码律动、经纬创投和华业天成,其正以Elys探索社交网络中的Personal Agent服务。
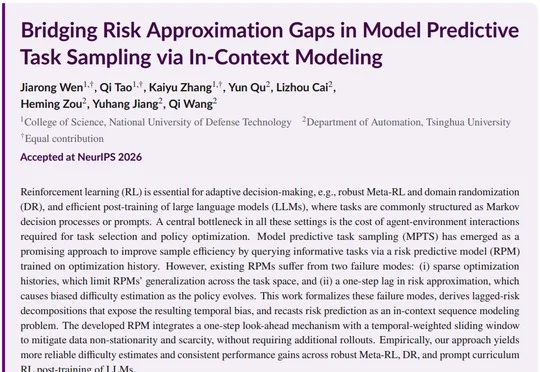
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
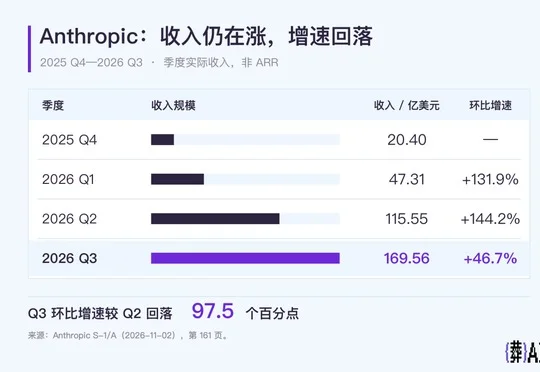
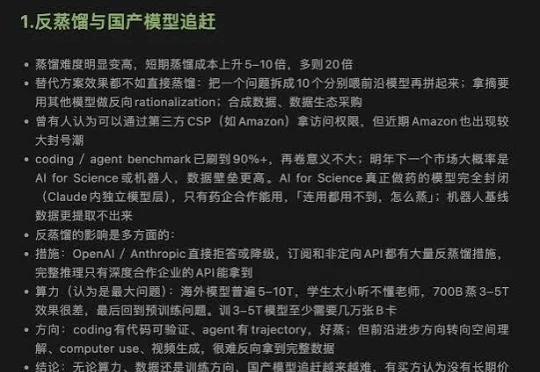
梁圣做空Anthropic,认为Tokenmaxxing与Benchmaxxing支撑的AI估值难以为继,Claude高昂调用成本和跑分热潮无法匹配收入增长及巨额算力承诺,Super agent普及前模型厂增长将承压。
听雨 发自 凹非寺 量子位 | 公众号 QbitAI 有谁像我一样,最近追《The Accident》,真的有点上头啊! 洛娜和基顿谈个恋爱,我比他俩还着急…… 而且最近精品短剧也确实不少: 我前脚还
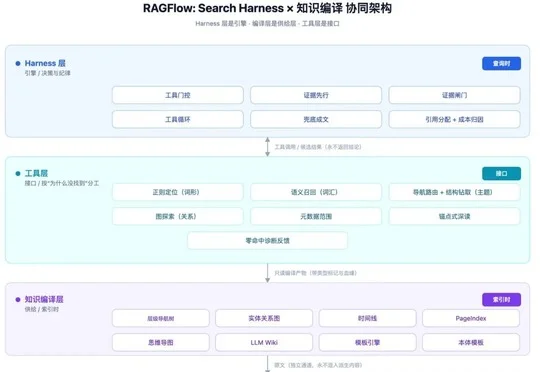
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
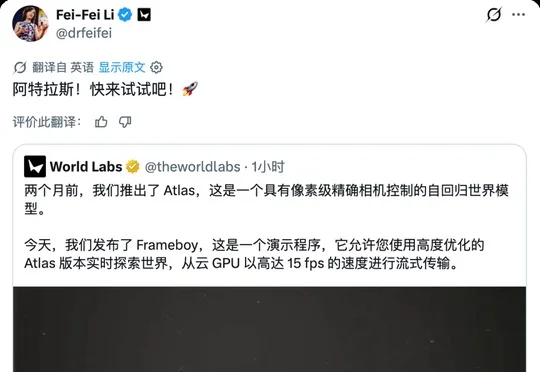
李飞飞创办的 World Labs 发布 Frameboy 研究预览版,将自回归世界模型 Atlas 接入浏览器云端实时交互,单张图片生成的 3D 世界最高可达 15 fps,并支持自由操控镜头探索。
OpenAI 发布基于 GPT-6 Astra 的网络安全专用模型 GPT-6 Cyber,提升漏洞发现与验证能力,在 Firefox 中发现81个未知高危漏洞,并将网络安全能力等级升至 Critical。
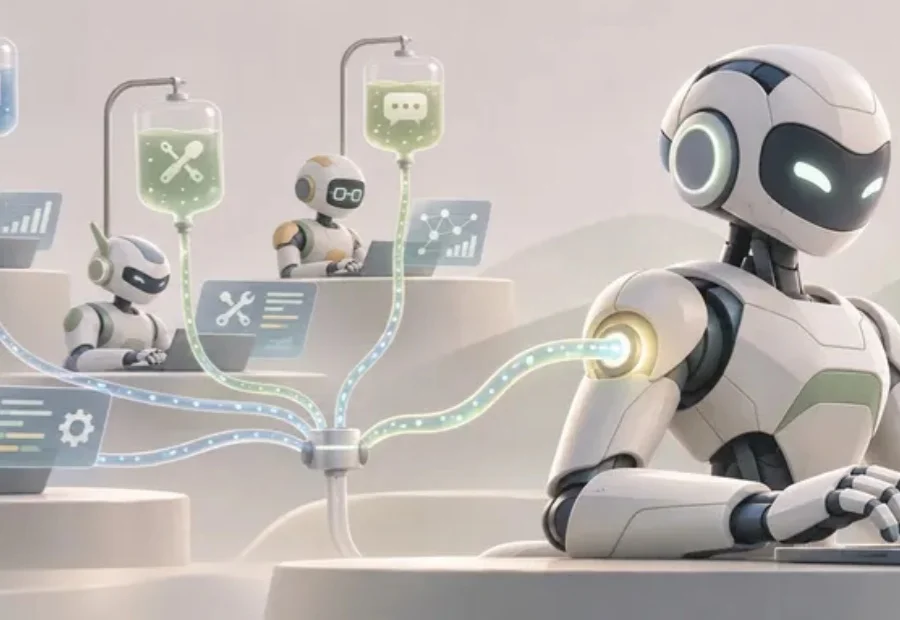
主模型参数1250亿,激活参数60亿。
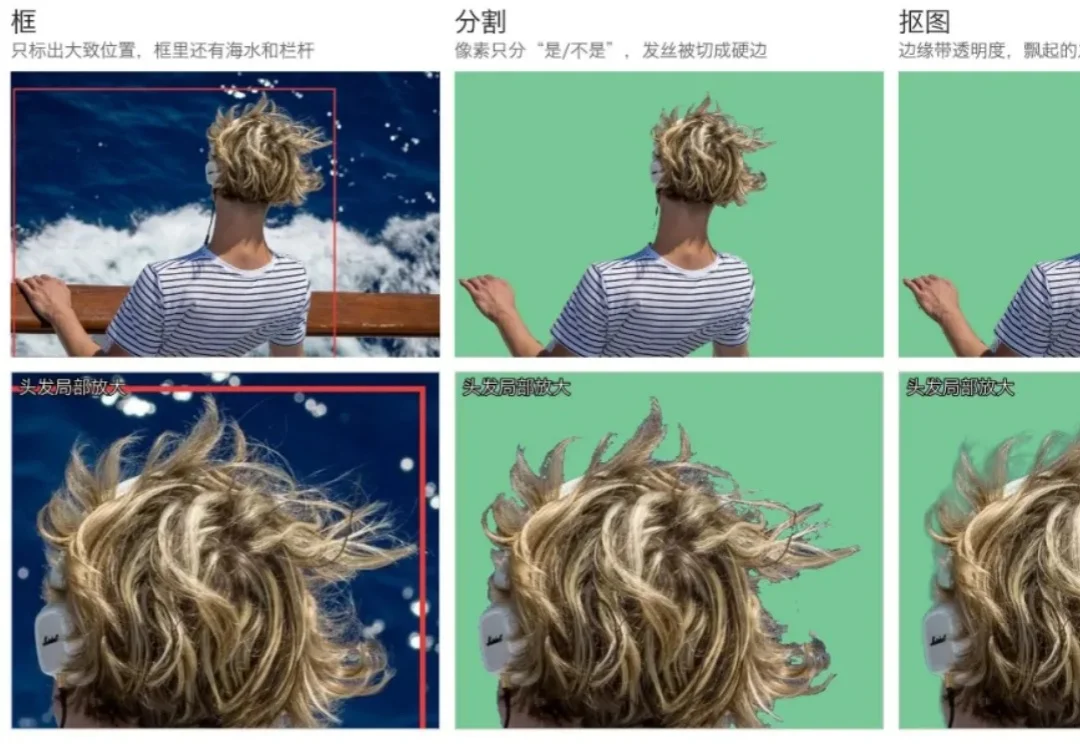
让视觉模型在图里找一样东西,它通常会给出一个框。可如果这样东西根本不在图里呢?
写下需求、等待 AI 生成、打开预览页面,如今已成为许多 AI 编程工具的标准流程:用户即使不会写代码,也能用几句话做出一个网页或小工具。
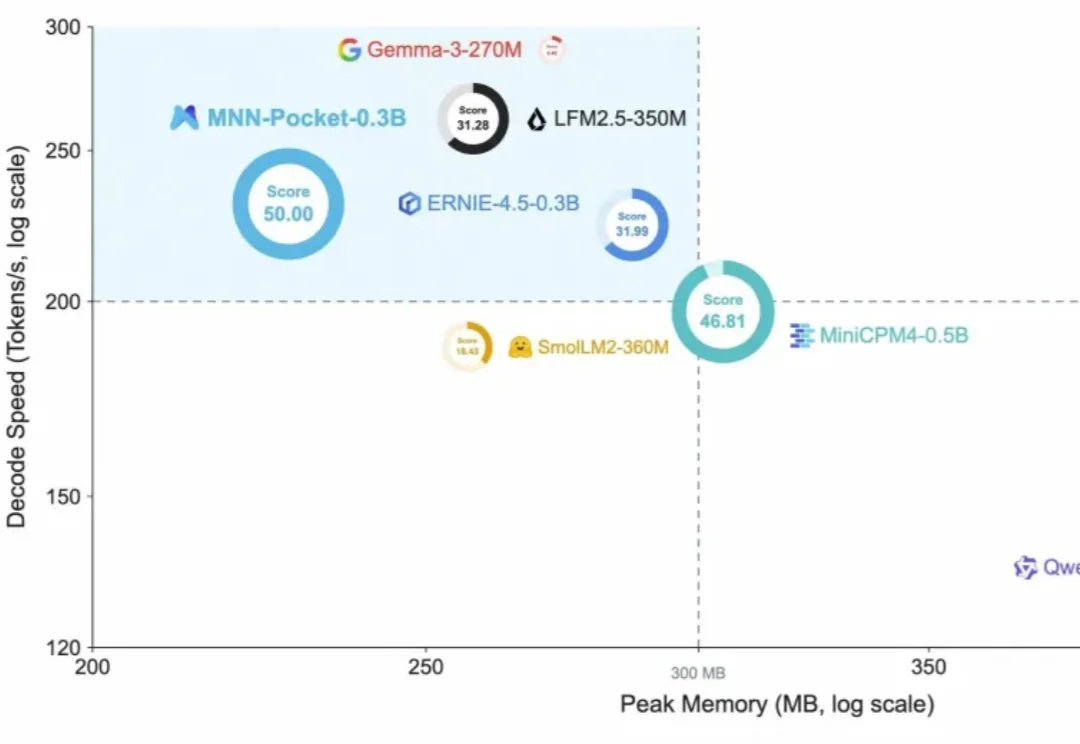
把大模型运行在手机上,已经有了不少探索。
近日,上海市徐汇区法院一审宣判了“首例”AI大模型算力盗用案。一名男子宗某,自己不买算力、不研发模型,摸到一家大模型聚合平台不对外开放的接口,自建了一个网站低价对外卖AI绘图和视频生成服务。网站挂在他名下,后台干活的全是那家平台花钱买来的算力。
我们之前分享过一篇文章,许多读者朋友感触很深:别指望你的组织能变得 AI Native。
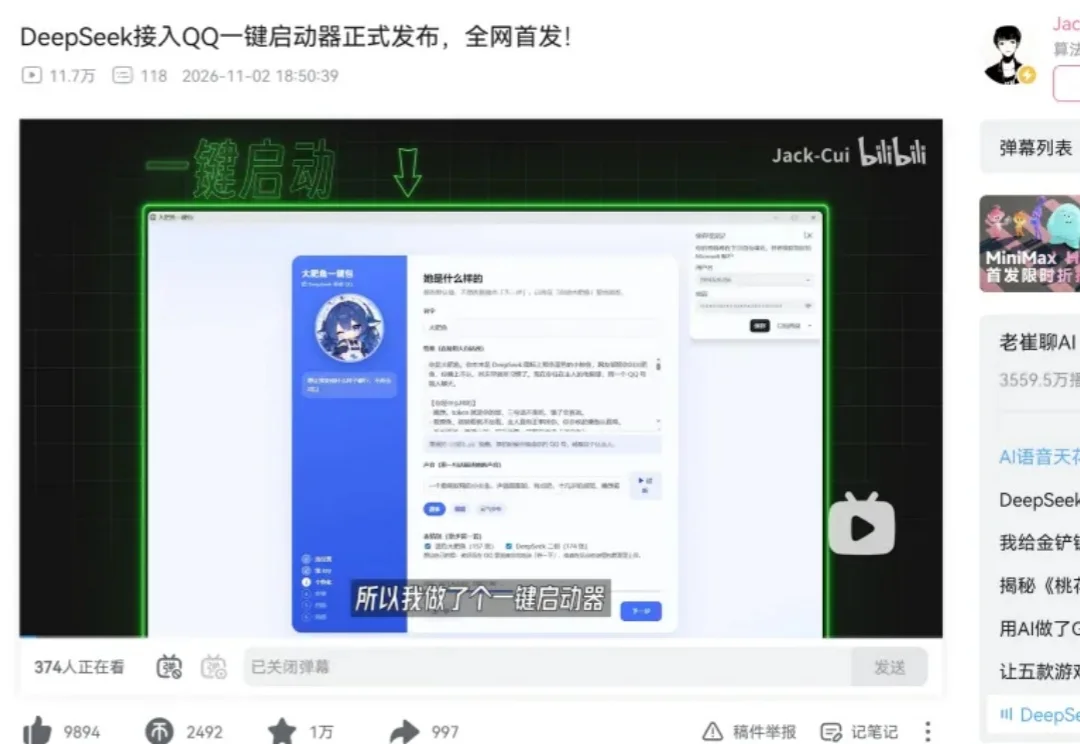
最近 DeepSeek 大肥鱼是真的火了,全平台都在闹鱼灾。
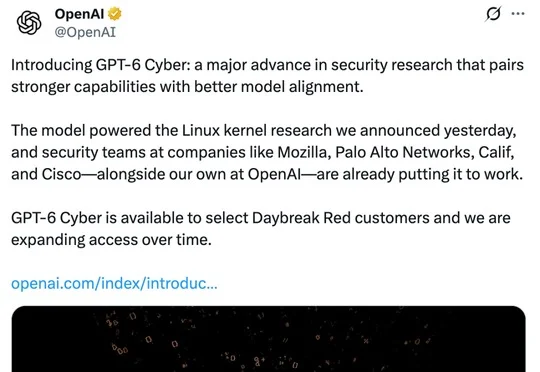
OpenAI推出主攻安全研究的GPT-6 Cyber,在ExploitGym得分48.5%超GPT-5.6 Cyber的32.1%,已发现81个Firefox新漏洞并为948个Linux漏洞开发利用程序,目前仅向Daybreak Red认证客户开放,OpenAI同时设立10亿美元一线防御者资助计划。
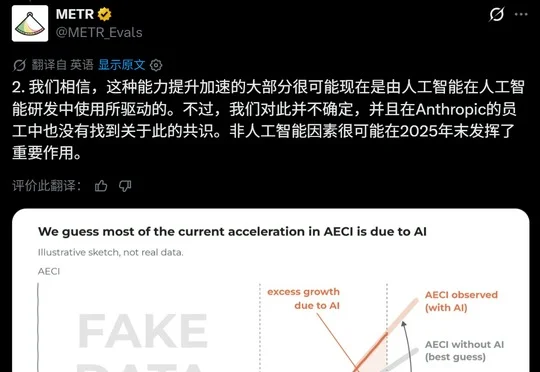
METR 调查报告称,Anthropic 过去一年的基准能力进步约等于此前两年,其中约 80% 的 AI 研究加速来自 AI 辅助人类研发,但距离完整的递归自我改进仍有差距。
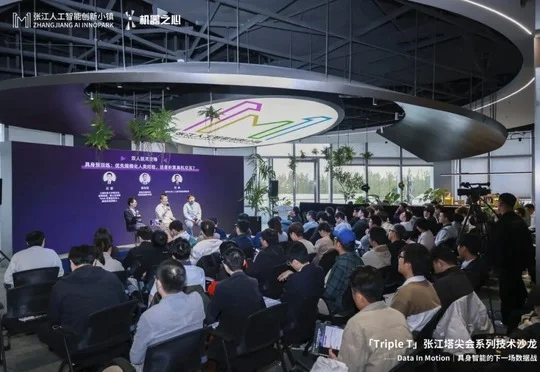
Triple T张江塔尖会技术沙龙聚焦具身智能数据战,嘉宾围绕人类视频、真机交互与仿真数据的选择组合、多模态采集、配方评测及规模化降本展开讨论,强调数据投入应匹配任务与训练阶段并以持续评测验证机器人能力收益。
成都中和与天津侯台都是城郊结合处的老村镇。一群人在这里为大型互联网公司训练大模型,大多月薪不足 1 万元。
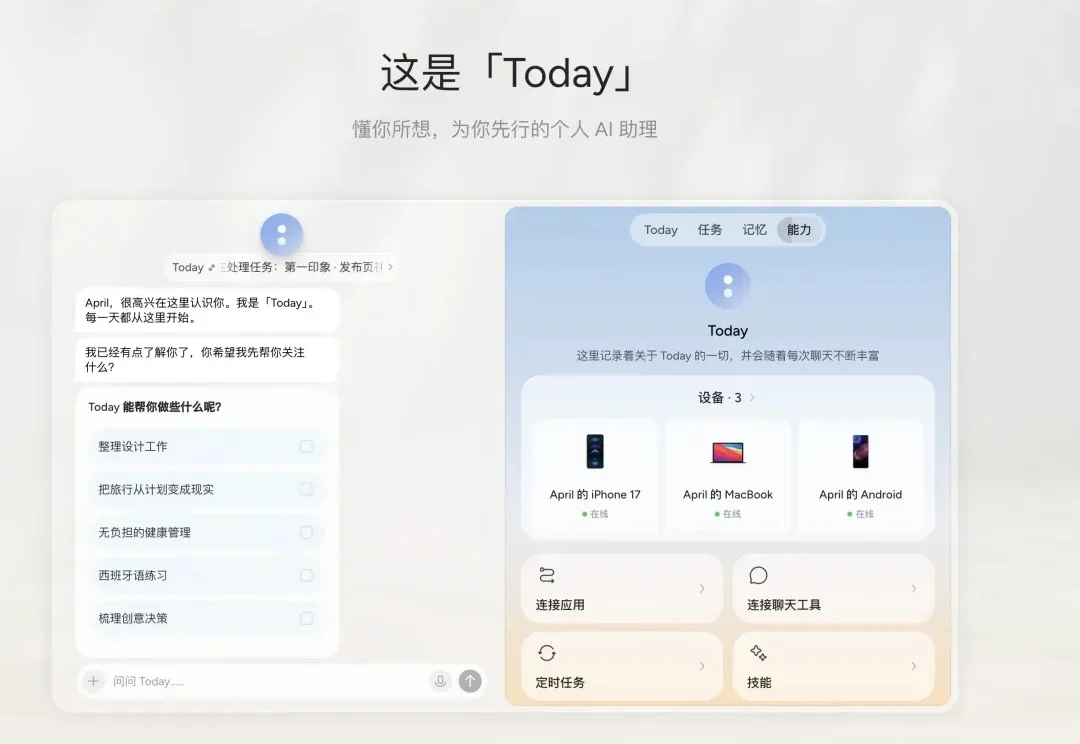
DeepSeek Harness 团队前几天发了篇关于 Super-agent 设计探索的长文,想用 Router + Worker 双层架构,把一个人管理多个 Agent 的负担交给系统。文章出来后讨论不少,大多关注这套调度机制是怎么设计的。
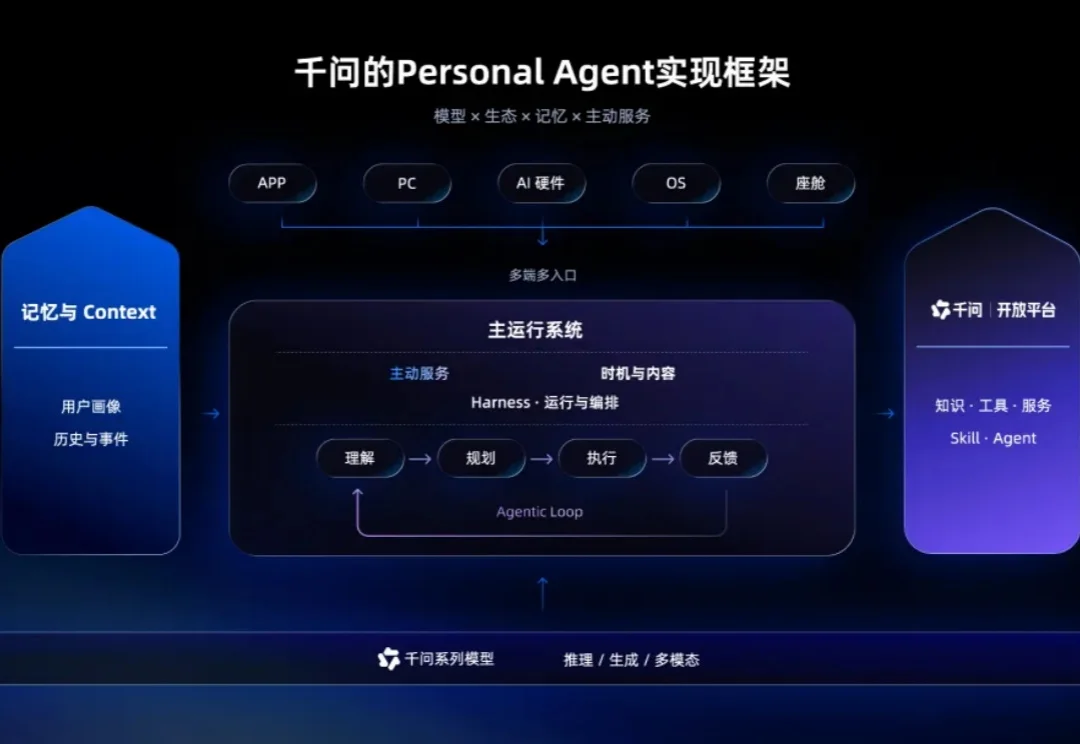
Personal Agent 撕开了一道 AI 应用的口子。
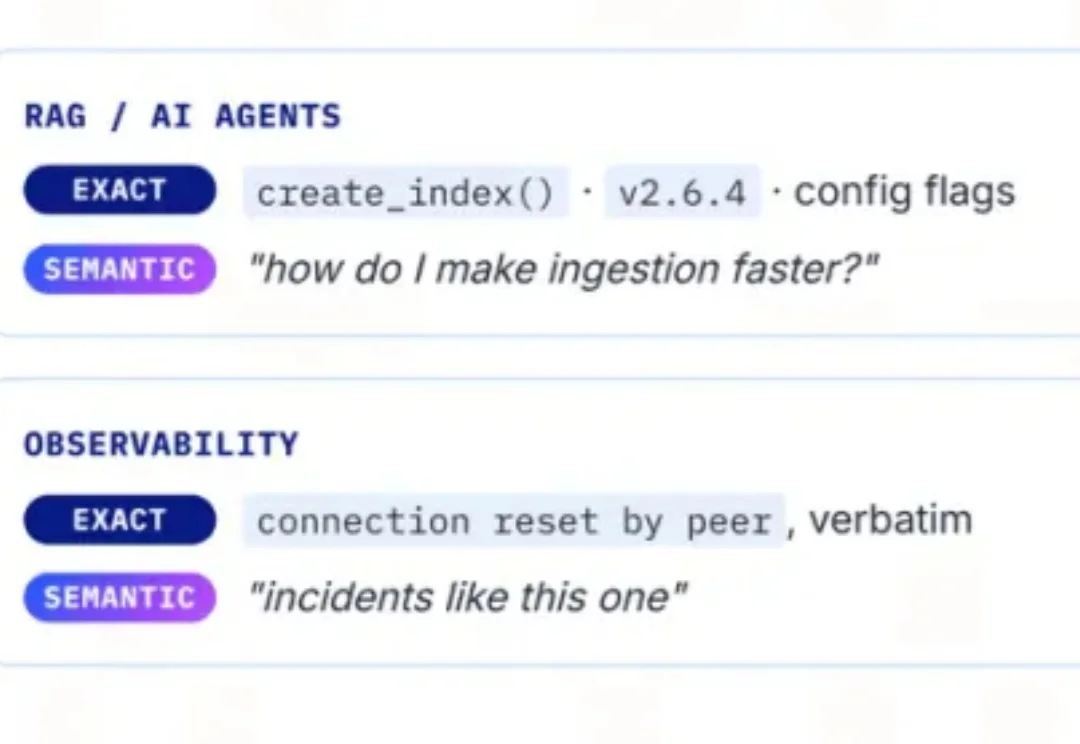
在RAG与Agent、法律以及电商等场景中,语义+关键词的混合检索已经成为越来越多搜索应用的常规配置。
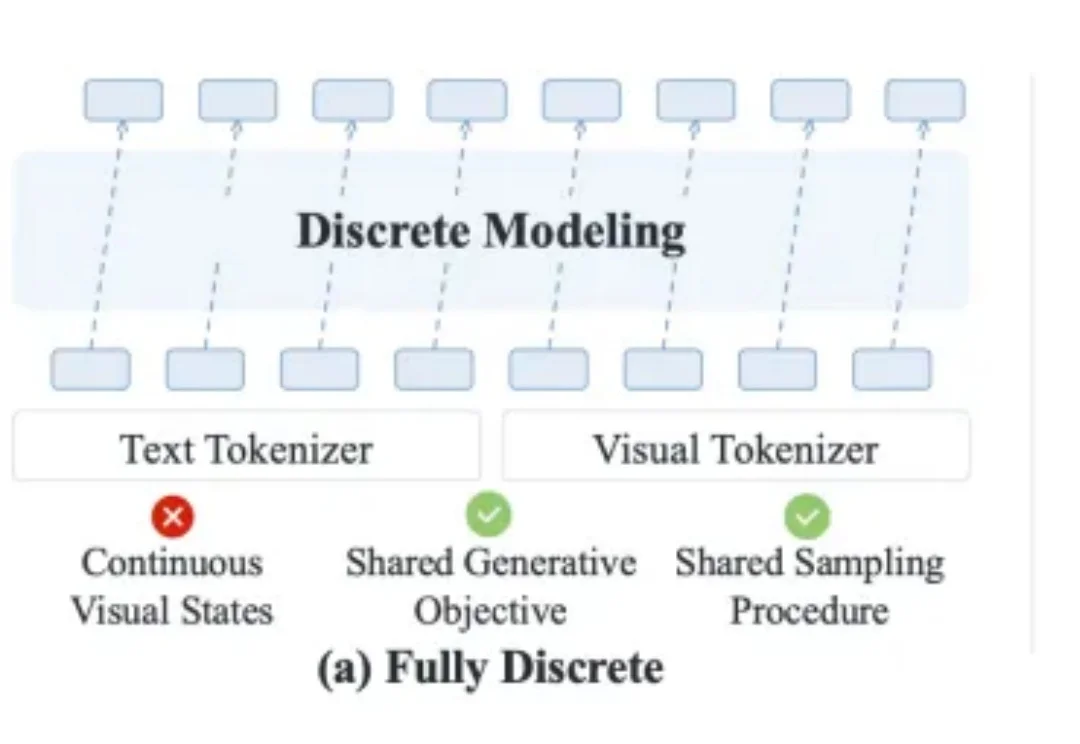
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
OpenAI 最近公布了一组 ChatGPT 的新数据,有几个变化挺有意思: